- 26
- กันยายน
"ใช้ AI ทำ Porter's Five Forces ได้แค่ไหน? ตอนที่ 4 กับ Anthropic ให้ AI ประเมินแรงกดดันในตลาดโมเดล AI แล้วเถียงตัวเอง" — คำตอบสั้นที่สุดคือ ให้คะแนนแรงกดดันทั้ง 5 พร้อมหลักฐานได้ในสิบนาที แต่คะแนนที่ดูมั่นใจนั้นพลิกได้ เมื่อสั่งให้ Claude เถียงตัวเองด้วยเอกสารชุดเดิม คะแนน 1 ใน 5 พลิกจากสูงเป็นกลาง อีก 2 แรงลดความมั่นใจ และ AI จับได้เองว่านับซ้ำ บทความนี้เป็นตอนที่ 4 ต่อจาก BMC, SWOT/TOWS และ CVP ทดลองจริงกับตลาดที่ Anthropic แข่งอยู่ด้วยเอกสาร 31 รายการ เอาผลมาให้ดูทั้งแผนภาพและตาราง แล้วสรุปเป็นวิธีเอาไปใช้กับอุตสาหกรรมของคุณเอง
สรุปสั้นๆ: AI ให้คะแนน Porter's Five Forces ของตลาดโมเดล AI ระดับ frontier: ขั้นแรก สูง 3 กลาง 2 เมื่อสั่งให้เถียงตัวเองด้วยเอกสารชุดเดิม 31 รายการ สินค้าทดแทนพลิกจากสูงเป็นกลาง ลดความมั่นใจ 2 แรง จับได้ว่านับซ้ำ 1 จุด และเขียนเงื่อนไข "สิ่งที่จะทำให้เปลี่ยนใจ" ครบทุกแรง
หมายเหตุก่อนอ่าน: บทความนี้เป็นตอนที่ 4 ต่อจาก Business Model Canvas SWOT และ TOWS และ Customer Value Proposition ทดลองวันที่ 26 กันยายน 2569 ด้วย Claude (โมเดล Claude Fable 5.1 ผ่าน Claude Code) ปิดการค้นเว็บ ให้ AI ตอบจากเอกสารแนบ 31 รายการเท่านั้น คะแนนทุกแรงเป็นการตีความของ AI จากเอกสารสาธารณะ ไม่ใช่ข้อสรุปของ Anthropic ตัวเลขรายได้แบบ run-rate และอัตรากำไรเป็นรายงานข่าวหรือประมาณการของบุคคลที่สาม เรากำกับไว้ทุกจุด ราคาเป็นดอลลาร์สหรัฐ ไม่แปลงเป็นบาท และขอแจ้งให้ชัดเหมือนสามตอนแรก บริษัทเราจำหน่ายและจัดหา Claude ให้องค์กรไทย แต่เขียนจากข้อมูลสาธารณะเท่านั้น
สามตอนแรกมองจากในบริษัทออกไป ตอนนี้ถอยออกมามองทั้งอุตสาหกรรมด้วยเครื่องมือที่เก่าที่สุดในชุด คือ Porter's Five Forces และเพิ่มกติกาใหม่หนึ่งข้อที่ทำให้ตอนนี้ต่างจากสามตอนก่อน หลังจาก AI ให้คะแนนแรงกดดันทั้ง 5 แล้ว เราสั่งให้มันทำหน้าที่ "ฝ่ายค้าน" เถียงคะแนนของตัวเองด้วยเอกสารชุดเดิม ผลคือคะแนน 1 ใน 5 พลิก อีก 2 แรงลดความมั่นใจ และ AI จับได้เองว่าตัวเองนับซ้ำ
1. Porter's Five Forces คืออะไร และทำไมต้องให้ AI เถียงตัวเอง
Porter's Five Forces คือกรอบของ Michael Porter (ฉบับปรับปรุงใน Harvard Business Review ปี 2551) ที่บอกว่ากำไรของอุตสาหกรรมหนึ่งถูกกำหนดด้วยแรงกดดัน 5 แรง ไม่ใช่ด้วยความเก่งของบริษัทใดบริษัทหนึ่ง ถ้าแรงส่วนใหญ่สูง ต่อให้เป็นผู้นำตลาดก็กำไรบาง ถ้าแรงส่วนใหญ่ต่ำ บริษัทธรรมดาก็อยู่สบาย งานของนักวิเคราะห์คือให้คะแนนแต่ละแรงว่า สูง กลาง หรือต่ำ พร้อมหลักฐาน
| แรง | คำถามที่ต้องตอบ | สิ่งที่ทำให้แรงสูง | ในตลาดโมเดล AI คือใคร |
|---|---|---|---|
| การแข่งขันในอุตสาหกรรม (rivalry) | คู่แข่งที่มีอยู่แย่งกันรุนแรงแค่ไหน | คู่แข่งขนาดใกล้กัน ต้นทุนคงที่สูง สินค้าต่างกันน้อย ตลาดโตช้า | OpenAI, Google และ Anthropic |
| ภัยจากผู้เข้าใหม่ (new entrants) | คนนอกเข้ามาแข่งได้ง่ายแค่ไหน | ใช้ทุนน้อย ไม่มีกฎเกณฑ์กั้น เข้าถึงช่องทางได้ | ใครก็ตามที่มีเงิน ชิป และช่องทางขาย |
| อำนาจต่อรองของซัพพลายเออร์ | คนขายวัตถุดิบให้เรากำหนดราคาได้แค่ไหน | ซัพพลายเออร์น้อยราย ย้ายค่ายยาก ซัพพลายเออร์ทำสินค้าแข่งได้เอง | ผู้ผลิตชิป ผู้ให้บริการคลาวด์ พลังงาน และบุคลากรวิจัย |
| อำนาจต่อรองของผู้ซื้อ | ลูกค้าบีบราคาเราได้แค่ไหน | ลูกค้ารายใหญ่ไม่กี่ราย ย้ายค่ายง่าย สินค้าเทียบกันได้ | องค์กร นักพัฒนา และคลาวด์ในฐานะช่องทางขาย |
| ภัยจากสินค้าทดแทน (substitutes) | ลูกค้าแก้ปัญหาเดียวกันด้วยวิธีอื่นได้ไหม | ของทดแทนถูกกว่ามาก ย้ายไปใช้ได้ง่าย | โมเดล open-weight ที่โฮสต์เอง โมเดลที่ผู้ซื้อทำเอง หรือไม่ใช้ AI |
สิ่งที่ทำให้ Five Forces เหมาะกับการทดสอบ AI มากกว่ากรอบอื่นคือ คะแนนมันดูมั่นใจเสมอ คนอ่านเห็นคำว่า "สูง" พร้อมหลักฐาน 5 ข้อ ก็เชื่อ ทั้งที่ Porter เองเขียนไว้ว่าคะแนนขึ้นกับการกำหนดขอบเขตอุตสาหกรรมและขอบฟ้าเวลา เปลี่ยนสองอย่างนี้ คะแนนเปลี่ยนโดยที่ข้อเท็จจริงไม่เปลี่ยนเลย คำถามของเราจึงไม่ใช่แค่ AI ให้คะแนนได้ไหม แต่คือถ้าบังคับให้มันเถียงคะแนนตัวเอง มันจะยอมรับตรงไหนว่าคะแนนยืนอยู่บนมุมมอง ไม่ใช่บนข้อมูล
หลักที่ใช้ตอนนี้: ทำสองขั้นด้วยเอกสารชุดเดียวกัน ขั้นแรกให้คะแนน ขั้นที่สองสั่งให้เถียงว่าคะแนนควรเป็นตรงข้าม ห้ามเพิ่มข้อเท็จจริงใหม่ แล้วให้ชั่งสองฝั่งเอง สิ่งที่บังคับให้เขียนทุกแรงคือ "สิ่งที่จะทำให้เปลี่ยนใจ" เพราะคะแนนที่ไม่มีเงื่อนไขเปลี่ยน คือคะแนนที่ตรวจไม่ได้
ใช้ Claude ในองค์กร? ขอใบเสนอราคาเป็นเงินบาท พร้อมใบกำกับภาษี
บริการจัดหาของเรารับตั้งแต่ 5 ที่นั่ง · น้อยกว่านั้นแนะนำซื้อตรงจาก Anthropic · Enterprise ปรึกษาทีมขาย
2. วิธีทดลอง: ให้คะแนนก่อน แล้วสั่งให้เถียงคะแนนตัวเอง
เอกสารแนบ 31 รายการคือ 25 รายการจากตอนที่แล้ว บวก 6 รายการที่ Five Forces ต้องมีแต่สามตอนก่อนไม่ต้องใช้ ได้แก่ ผลประกอบการ NVIDIA ไตรมาสล่าสุด (ฝั่งซัพพลายเออร์ชิป) รายงานการย้ายงานของบุคลากร AI ของ SignalFire ประมาณการต้นทุนฝึกโมเดลของ Epoch AI ผลสำรวจ CIO 100 รายของ Andreessen Horowitz บทความต้นฉบับของ Porter ใน HBR และสรุปข้อสรุปตอนที่ 1–3 ของเราเองเป็นรายการที่ 31 เพื่อให้ AI ตรวจความสอดคล้องกับสิ่งที่มันเคยสรุปไว้
คุณเป็นที่ปรึกษากลยุทธ์ธุรกิจ ช่วยทำ Porter's Five Forces ของอุตสาหกรรม
"โมเดล AI ระดับ frontier สำหรับองค์กร" ซึ่งเป็นตลาดที่ Anthropic แข่งอยู่
จากเอกสารแนบด้านล่าง

กติกา
1. ตอบเป็นภาษาไทย ภาษาคนทำงาน ไม่ต้องเกริ่น
2. ทำครบ 5 แรง: การแข่งขันในอุตสาหกรรม · ภัยจากผู้เข้าใหม่ · อำนาจต่อรองของ
   ซัพพลายเออร์ (ชิป คลาวด์ พลังงาน บุคลากร) · อำนาจต่อรองของผู้ซื้อ (องค์กร
   นักพัฒนา และไฮเปอร์สเกลเลอร์ในฐานะช่องทาง) · ภัยจากสินค้าทดแทน (โมเดล
   open-weight ที่โฮสต์เอง โมเดลที่ผู้ซื้อทำเอง หรือไม่ใช้ AI)
3. แต่ละแรงให้ (ก) คะแนน สูง / กลาง / ต่ำ (ข) ปัจจัย 3–5 ข้อ ตั้งรหัส R1, N1,
   S1, B1, T1 ... ทุกข้ออ้าง [n] และกำกับว่า ข้อเท็จจริง หรือ ตีความ
   (ค) "สิ่งที่จะทำให้คะแนนเปลี่ยน" 1–2 ข้อ (ง) ผลต่อ Anthropic 1 ประโยค
4. ห้ามเดาตัวเลข ถ้าเอกสารไม่ครอบคลุมให้กำกับ (ความรู้เดิม อาจล้าสมัย)
5. ปิดท้ายด้วย (ก) ตารางสรุป 5 แรง: คะแนน · ความมั่นใจ · เหตุผลสั้น
   (ข) ตาราง "สิ่งที่คนต้องตัดสินใจหรือตรวจสอบเพิ่ม"
6. ไม่ต้องค้นเว็บ
คำสั่งขั้นที่สองแนบผลขั้นแรกทั้งฉบับกับเอกสารชุดเดิม แล้วเปลี่ยนบทบาท
ต่อจาก Porter's Five Forces ด้านล่าง ขอให้คุณทำหน้าที่ "ฝ่ายค้าน"
เถียงคะแนนของแต่ละแรงด้วยเอกสารชุดเดียวกัน

กติกา
1. ตอบเป็นภาษาไทย ภาษาคนทำงาน ไม่ต้องเกริ่น
2. แต่ละแรงให้ (ก) ข้อโต้แย้งที่แข็งที่สุดว่าคะแนนควรเป็นตรงข้าม (ถ้าเดิมสูง
   ให้เถียงว่ากลางหรือต่ำ ถ้าเดิมต่ำ ให้เถียงว่าสูง) ทุกข้ออ้าง [n] ห้ามเพิ่ม
   ข้อเท็จจริงใหม่ที่ไม่มีในเอกสารแนบ (ข) จุดอ่อนของข้อโต้แย้งนั้นเอง
   (ค) คะแนนสุดท้ายหลังชั่งสองฝั่ง พร้อมความมั่นใจ และบอกว่าเปลี่ยนจากเดิม
   หรือไม่ เพราะอะไร (ง) "สิ่งที่จะทำให้ผมเปลี่ยนใจ" คือหลักฐานอะไรที่ถ้าได้เห็น
   จะกลับคะแนน
3. ตรวจความสอดคล้องกับตอนก่อน [31]: คะแนนสุดท้ายหนุนหรือขัดข้อสรุปของ
   SWOT/TOWS/CVP ตรงไหน ระบุรหัสข้อ
4. ปิดท้ายด้วย (ก) ตารางสรุป (ข) ตาราง "สิ่งที่คนต้องตัดสินใจ" ที่ขึ้นกับมุมมอง
   หรือความเสี่ยงที่ยอมรับได้ ไม่ใช่ข้อมูล
5. ไม่ต้องค้นเว็บ
กติกาข้อ 2 (ก) "ห้ามเพิ่มข้อเท็จจริงใหม่" สำคัญที่สุด เพราะถ้าปล่อยให้ฝ่ายค้านหาหลักฐานใหม่ได้ มันจะชนะเสมอ สิ่งที่เราอยากรู้คือเอกสารชุดเดิมรองรับคะแนนตรงข้ามได้แค่ไหน วิธีเขียนกติกาแบบนี้เราอธิบายไว้ใน คู่มือเขียน prompt ให้ Claude สองขั้นใช้เวลาขั้นละราว 5–7 นาที ได้คำตอบราว 13,000 และ 18,600 ตัวอักษร ขั้นฝ่ายค้านยาวกว่าขั้นให้คะแนน เพราะต้องเขียนทั้งข้อโต้แย้ง จุดอ่อนของข้อโต้แย้ง และคำตัดสิน
3. ผลขั้นที่ 1: สูง 3 แรง กลาง 2 แรง และคำอธิบายที่ฟังดูลงตัวเกินไป
AI เริ่มด้วยการกำหนดขอบเขตเอง คือตลาดขายโมเดล frontier ให้องค์กรผ่าน API คลาวด์ และเครื่องมือ ผู้เล่นหลักตามเอกสารมี 3 ราย และจัดโมเดลจีนกับ open-weight เป็นสินค้าทดแทนตามโจทย์ที่เราให้ จากนั้นให้คะแนนทั้ง 5 แรงพร้อมปัจจัย 25 ข้อ ทุกข้อมีเลขอ้างอิงและป้ายข้อเท็จจริงหรือตีความ
| แรง | คะแนน | มั่นใจ | เหตุผลสั้นที่ AI ให้ | ผลต่อ Anthropic (คำของ AI) |
|---|---|---|---|---|
| การแข่งขัน | สูง | สูง | ส่วนแบ่ง LLM API องค์กรสลับมือเร็ว (Anthropic 24% เป็น 40% OpenAI 50% เหลือ 27%) [17] · OpenAI ลดราคาราว 80% (ก.ค. 2569) [18] · ทุกรายมีกำลังผลิตที่ผูกพันไว้ล่วงหน้าต้องเติมให้เต็ม [7][8] | ต้องทำให้ความนำในงานโค้ดวัดได้ชัด เพราะทุกจุดที่วัดไม่ได้จะกลายเป็นการแข่งราคา |
| ผู้เข้าใหม่ | กลาง | กลาง | = ต่ำที่ระดับ frontier (ต้นทุนฝึกจะเกิน $1B) [28] + สูงที่ระดับใกล้ frontier (จีน 6 โมเดลใน 3 เดือน) [18] | คูเมืองจริงคือทุน compute และช่องทาง ไม่ใช่คุณภาพโมเดลอย่างเดียว |
| ซัพพลายเออร์ | สูง | สูง | compute กิน $0.56–0.71 ต่อรายได้ $1 (ประมาณการ) [11] · NVIDIA gross margin 74.9% [26] · คลาวด์เป็นทั้งผู้ถือหุ้น คู่แข่ง และช่องทาง [7][8][20] | เพดานอัตรากำไรราว 44% ถูกตั้งจากข้างนอกบริษัท |
| ผู้ซื้อ | กลาง | กลาง | 37% ขององค์กรใช้ 5 โมเดลขึ้นไป [29] แต่งานโค้ด "ไม่ไวต่อราคา" [22] ซึ่งเป็นหลักฐานก่อนช็อกราคา · ช่องทางอยู่ในมือคู่แข่ง | คิด premium ได้เฉพาะงานที่พิสูจน์ได้ว่าดีกว่าแบบวัดได้ |
| สินค้าทดแทน | สูง | กลาง | "เซนต์ vs ดอลลาร์" [18] แต่หลักฐานการใช้เป็นสตาร์ทอัพ ไม่ใช่องค์กรใหญ่ และราคาถูกไม่นิ่ง | ชั้นล่างของไลน์ราคาชนตรงกับ "เซนต์" ชั้นบนถูกป้องกันเฉพาะที่ช่องว่างคุณภาพวัดได้ |
ภาพรวมที่ AI สรุปคือ "3 ใน 5 แรงสูง สอดคล้องกับอัตรากำไรขั้นต้นราว 44%" อ่านแล้วลงตัวมาก และนั่นคือปัญหา สามอย่างที่ควรสังเกตก่อนไปขั้นที่ 2
- AI แยกชั้นเองโดยไม่ได้สั่ง ผู้เข้าใหม่แยกเป็น "ระดับ frontier แท้ = ต่ำ" กับ "ระดับใกล้ frontier = สูง" แล้วเฉลี่ยเป็นกลาง ผู้ซื้อแยกเป็นองค์กรใหญ่ นักพัฒนา และคลาวด์ในฐานะช่องทาง ให้คะแนนต่างกัน นี่คือสิ่งที่ที่ปรึกษาเก่งทำ และเป็นจุดที่ทำให้คะแนนรวมอ่านแล้วน่าเชื่อ
- AI ระบุวันที่ของหลักฐานเทียบกับวันที่ของภัย หลักฐานว่าผู้ซื้อ "ไม่ไวต่อราคา" และส่วนแบ่งงานโค้ด 54% เก็บเมื่อ พ.ย. 2568 ส่วนการลดราคา 80% ของคู่แข่งเกิด ก.ค. 2569 AI เขียนกำกับเองว่าหลักฐานเก่ากว่าภัย และใส่เป็นรายการแรกในตาราง "สิ่งที่ต้องตรวจสอบเพิ่ม" 12 รายการ
- แต่ AI ก็นับซ้ำโดยไม่รู้ตัว โมเดลจีน 6 ตัวถูกใช้ดันคะแนนผู้เข้าใหม่จากต่ำเป็นกลาง (ข้อ N2) และถูกใช้เป็นหลักฐานหลักของสินค้าทดแทน (ข้อ T1) พร้อมกัน ทั้งที่ขอบเขตที่มันกำหนดเองบอกว่าโมเดลจีนเป็นสินค้าทดแทน เราไม่ได้ทักตรงนี้ เพราะอยากรู้ว่าขั้นฝ่ายค้านจะจับได้เองไหม
กับดักของขั้นที่ 1: ผลลัพธ์ที่อธิบายทุกอย่างได้ลงตัว ("3 ใน 5 แรงสูง จึงกำไรบาง") คือผลลัพธ์ที่ควรสงสัยที่สุด เพราะกรอบ Five Forces ยืดหยุ่นพอที่จะอธิบายอัตรากำไรไหนก็ได้หลังจากรู้ตัวเลขแล้ว ถ้าหยุดที่ขั้นนี้ เราจะได้เอกสารที่อ่านลื่นและตรวจไม่ได้
4. ผลขั้นที่ 2: ฝ่ายค้านพลิก 1 แรง ลดความมั่นใจ 2 แรง และจับได้ว่านับซ้ำ
ตารางนี้คือทั้งกระบวนการในหน้าเดียว คอลัมน์ที่ 2 คือข้อโต้แย้งที่แข็งที่สุดที่ AI หาได้จากเอกสารชุดเดิม คอลัมน์ที่ 3 คือจุดอ่อนของข้อโต้แย้งนั้นที่ AI ชี้เอง คอลัมน์ที่ 4 คือคำตัดสิน และคอลัมน์สุดท้ายคือของที่มีค่าที่สุดในตอนนี้ คลิกที่ภาพเพื่อเปิดขนาดเต็ม
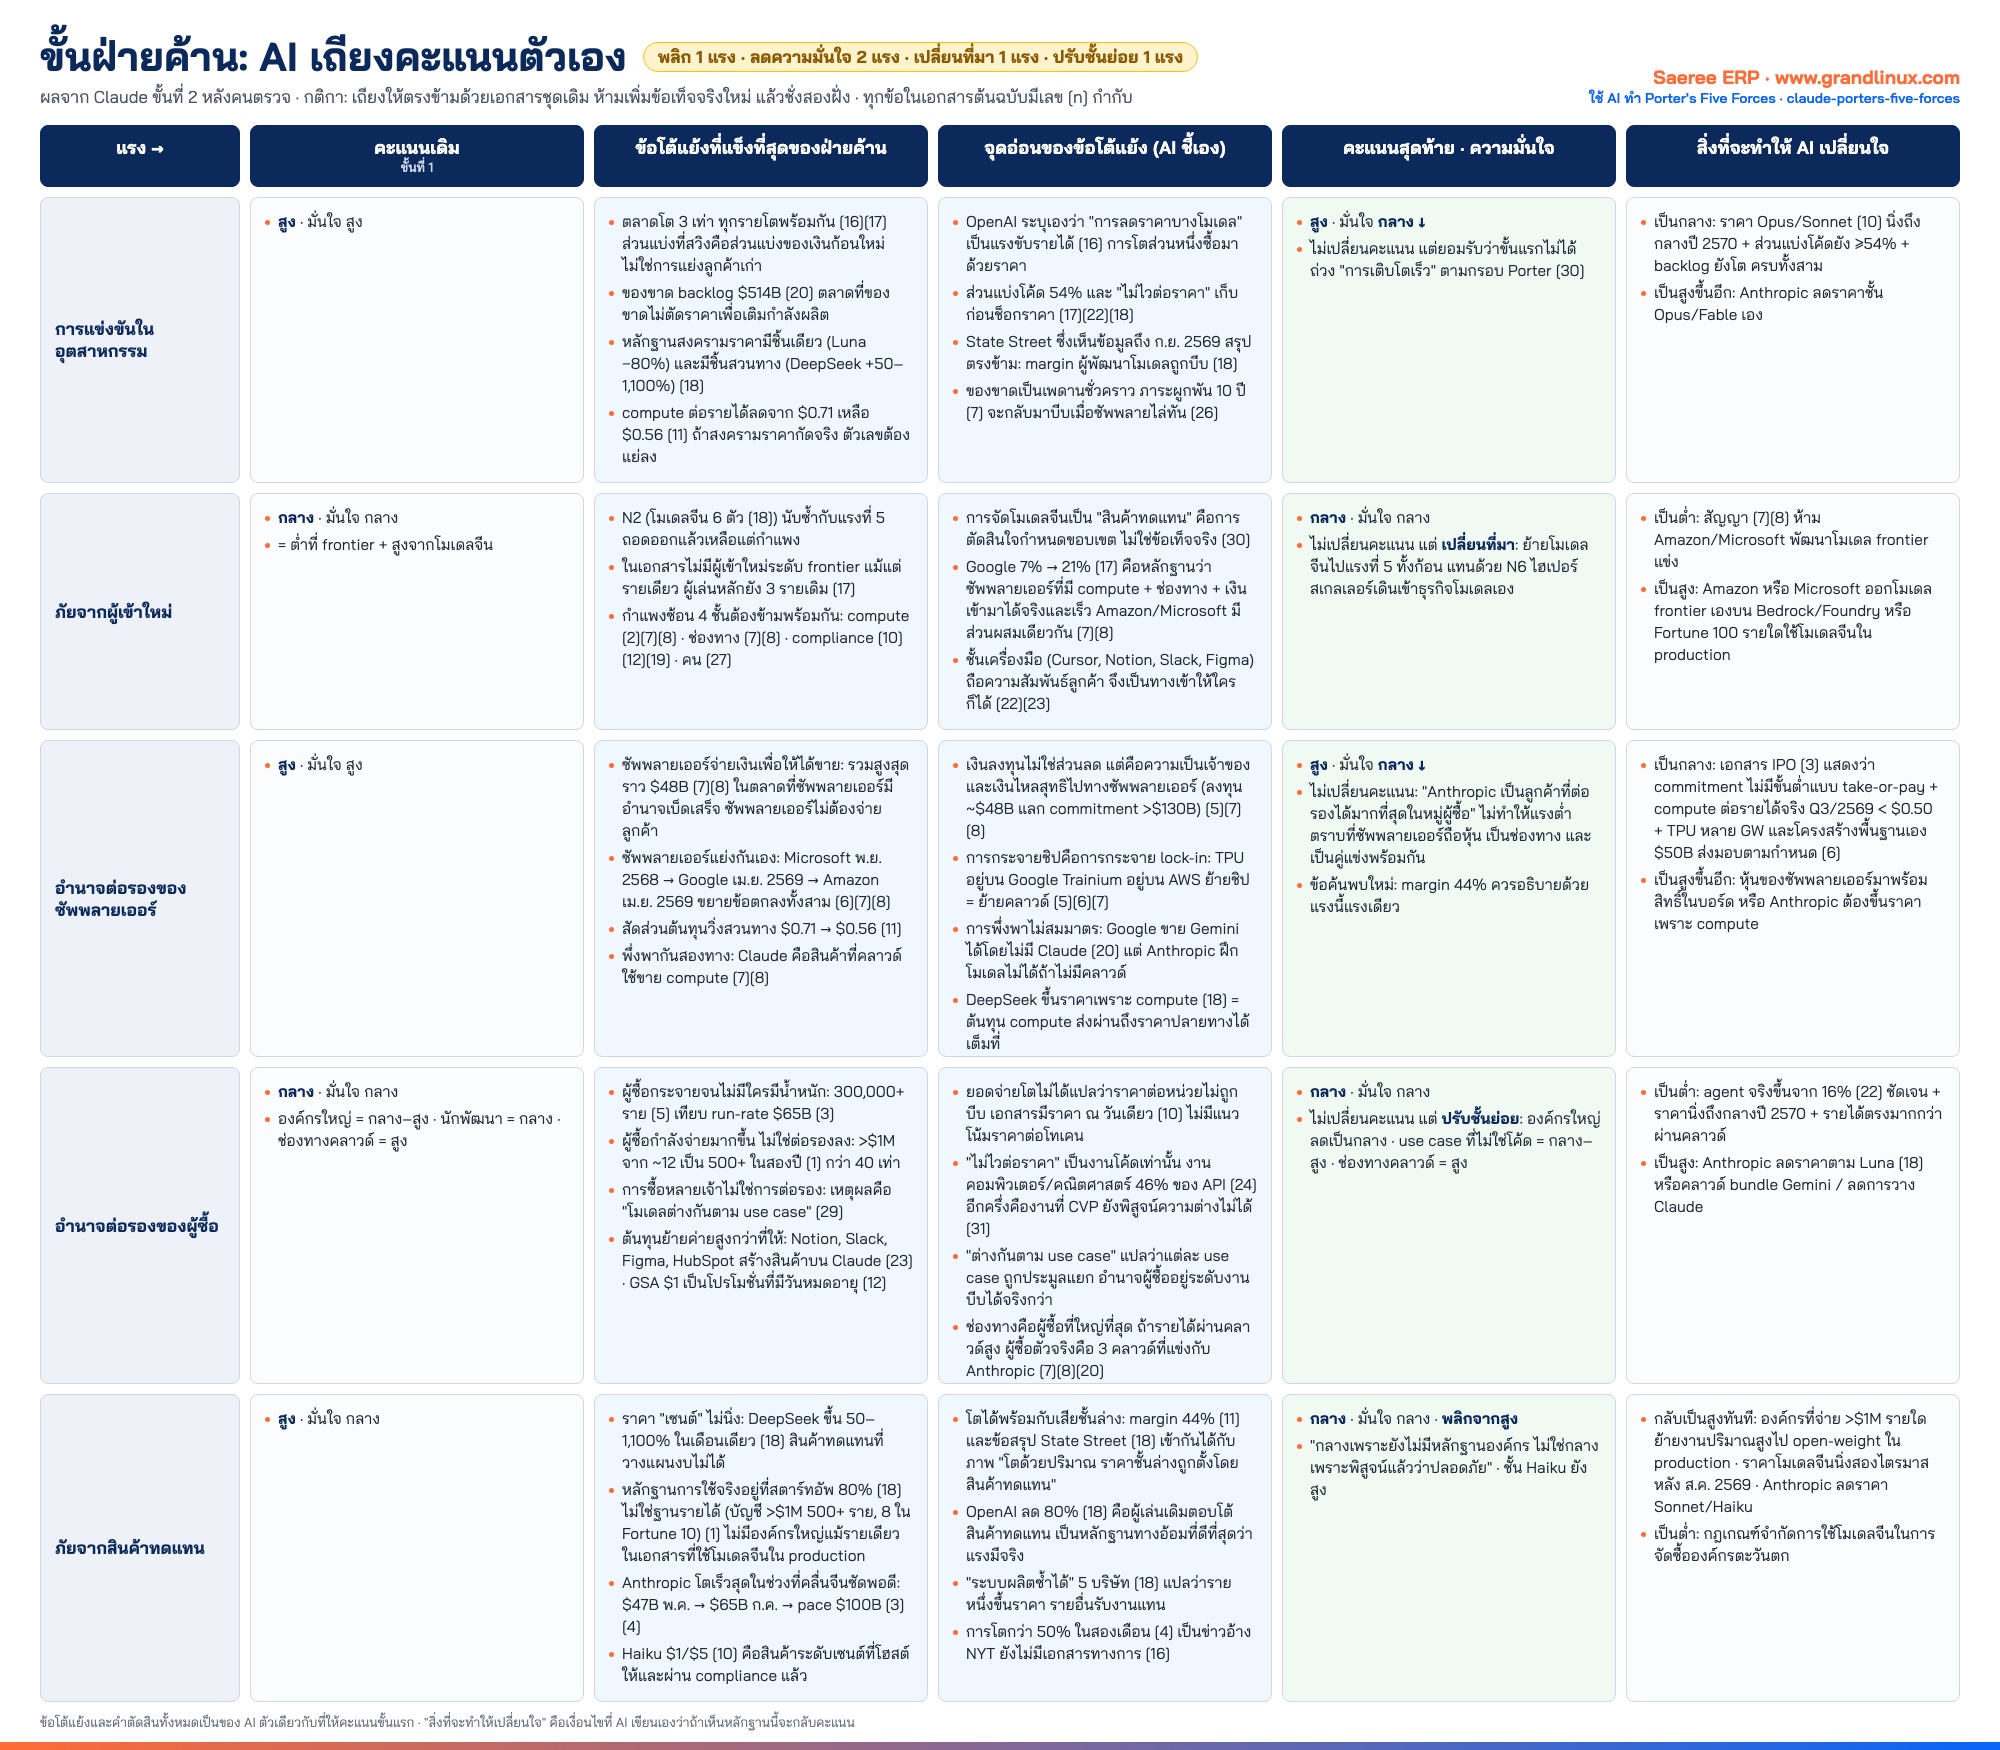
ขั้นฝ่ายค้านทั้ง 5 แรงในหน้าเดียว ข้อโต้แย้งและคำตัดสินเป็นของ AI ตัวเดียวกับที่ให้คะแนนขั้นแรก เราตัดให้สั้นลงเพื่อลงภาพ แต่ไม่ได้แก้เนื้อหา
สิ่งที่เกิดขึ้นทีละแรง
- สินค้าทดแทน พลิกจากสูงเป็นกลาง ฝ่ายค้านชี้ว่าคะแนนเดิมยืนบนสองขาที่เอกสารเองบั่นทอน ราคา "เซนต์" ไม่นิ่ง (DeepSeek ขึ้นราคา 50–1,100% ในเดือนเดียว) และหลักฐานการใช้ 80% เป็นสตาร์ทอัพ ไม่ใช่ฐานรายได้ที่เป็นบัญชีเกิน $1M กว่า 500 ราย ที่สำคัญคือประโยคที่ AI กำกับคำตัดสินเอง "กลางเพราะยังไม่มีหลักฐานองค์กร ไม่ใช่กลางเพราะพิสูจน์แล้วว่าปลอดภัย" และบอกว่าถ้าลูกค้ารายใหญ่รายใดย้ายงานไป open-weight ใน production ต้องกลับเป็นสูงทันที
- ผู้เข้าใหม่ คะแนนเท่าเดิมแต่ที่มาเปลี่ยน ฝ่ายค้านจับได้ว่า N2 นับซ้ำกับแรงที่ 5 AI ยอมรับ ย้ายโมเดลจีนไปแรงที่ 5 ทั้งก้อน แล้วแทนด้วยข้อใหม่ N6 ผู้เข้าใหม่ที่อันตรายคือคลาวด์ที่เป็นซัพพลายเออร์อยู่แล้ว โดยมี Google ที่ส่วนแบ่งขึ้นจาก 7% เป็น 21% เป็นตัวอย่างที่เกิดแล้ว คะแนนยังกลาง แต่แหล่งภัยชัดกว่าและใกล้กว่าเดิม
- การแข่งขัน สูงเท่าเดิม แต่ความมั่นใจลดจากสูงเป็นกลาง ฝ่ายค้านชนะประเด็นเดียวแต่สำคัญ คือตลาดที่โต 3 เท่าและของขาดเป็นปัจจัยที่ Porter ระบุว่าลดความรุนแรงของการแข่งขัน แต่ขั้นแรกไม่ได้ถ่วงเลย AI ตัดสินว่ามันจำกัดสงครามราคาแค่ตอนนี้ ไม่ได้ลบโครงสร้าง จึงคงคะแนนแต่ยอมรับว่าหลักฐานราคามีหนึ่งต่อหนึ่ง
- ซัพพลายเออร์ สูงเท่าเดิม ความมั่นใจลด และได้ข้อค้นพบใหม่ ฝ่ายค้านมีข้อเท็จจริงสองข้อที่ขั้นแรกมองข้าม ซัพพลายเออร์ประมูลกันเองและจ่ายเงินลงทุนเพื่อให้ได้ขาย และสัดส่วนต้นทุน compute ลดลง แต่ AI ตอบว่าเงินลงทุนคือความเป็นเจ้าของ ไม่ใช่ส่วนลด และเงินไหลสุทธิไปทางซัพพลายเออร์ ข้อค้นพบใหม่คือ อัตรากำไร 44% ควรอธิบายด้วยแรงนี้แรงเดียว ไม่ใช่ด้วย "3 ใน 5 แรงสูง" อย่างที่ภาพรวมเดิมสรุป
- ผู้ซื้อ กลางเท่าเดิม แต่ปรับชั้นย่อย ฝ่ายค้านถูกที่ว่าหลักฐานยอดจ่ายที่โตกว่า 40 เท่าและการที่ Notion, Slack, Figma สร้างสินค้าบน Claude ไม่รองรับคำว่า "สูง" สำหรับองค์กรใหญ่ AI ปรับองค์กรใหญ่ลงเป็นกลาง แต่ยกระดับ use case ที่ไม่ใช่โค้ดเป็นกลาง–สูง เพราะ "โมเดลต่างกันตาม use case" แปลว่าแต่ละงานถูกประมูลแยก
นี่คือผลสุดท้ายในเลย์เอาต์มาตรฐานของ Porter ป้ายสีคือคะแนนหลังขั้นฝ่ายค้าน บรรทัดเล็กใต้ป้ายคือคะแนนเดิมและความมั่นใจ ข้อความใต้เส้นประในแต่ละกล่องคือ "จะเปลี่ยนถ้า" ที่ AI เขียนเอง
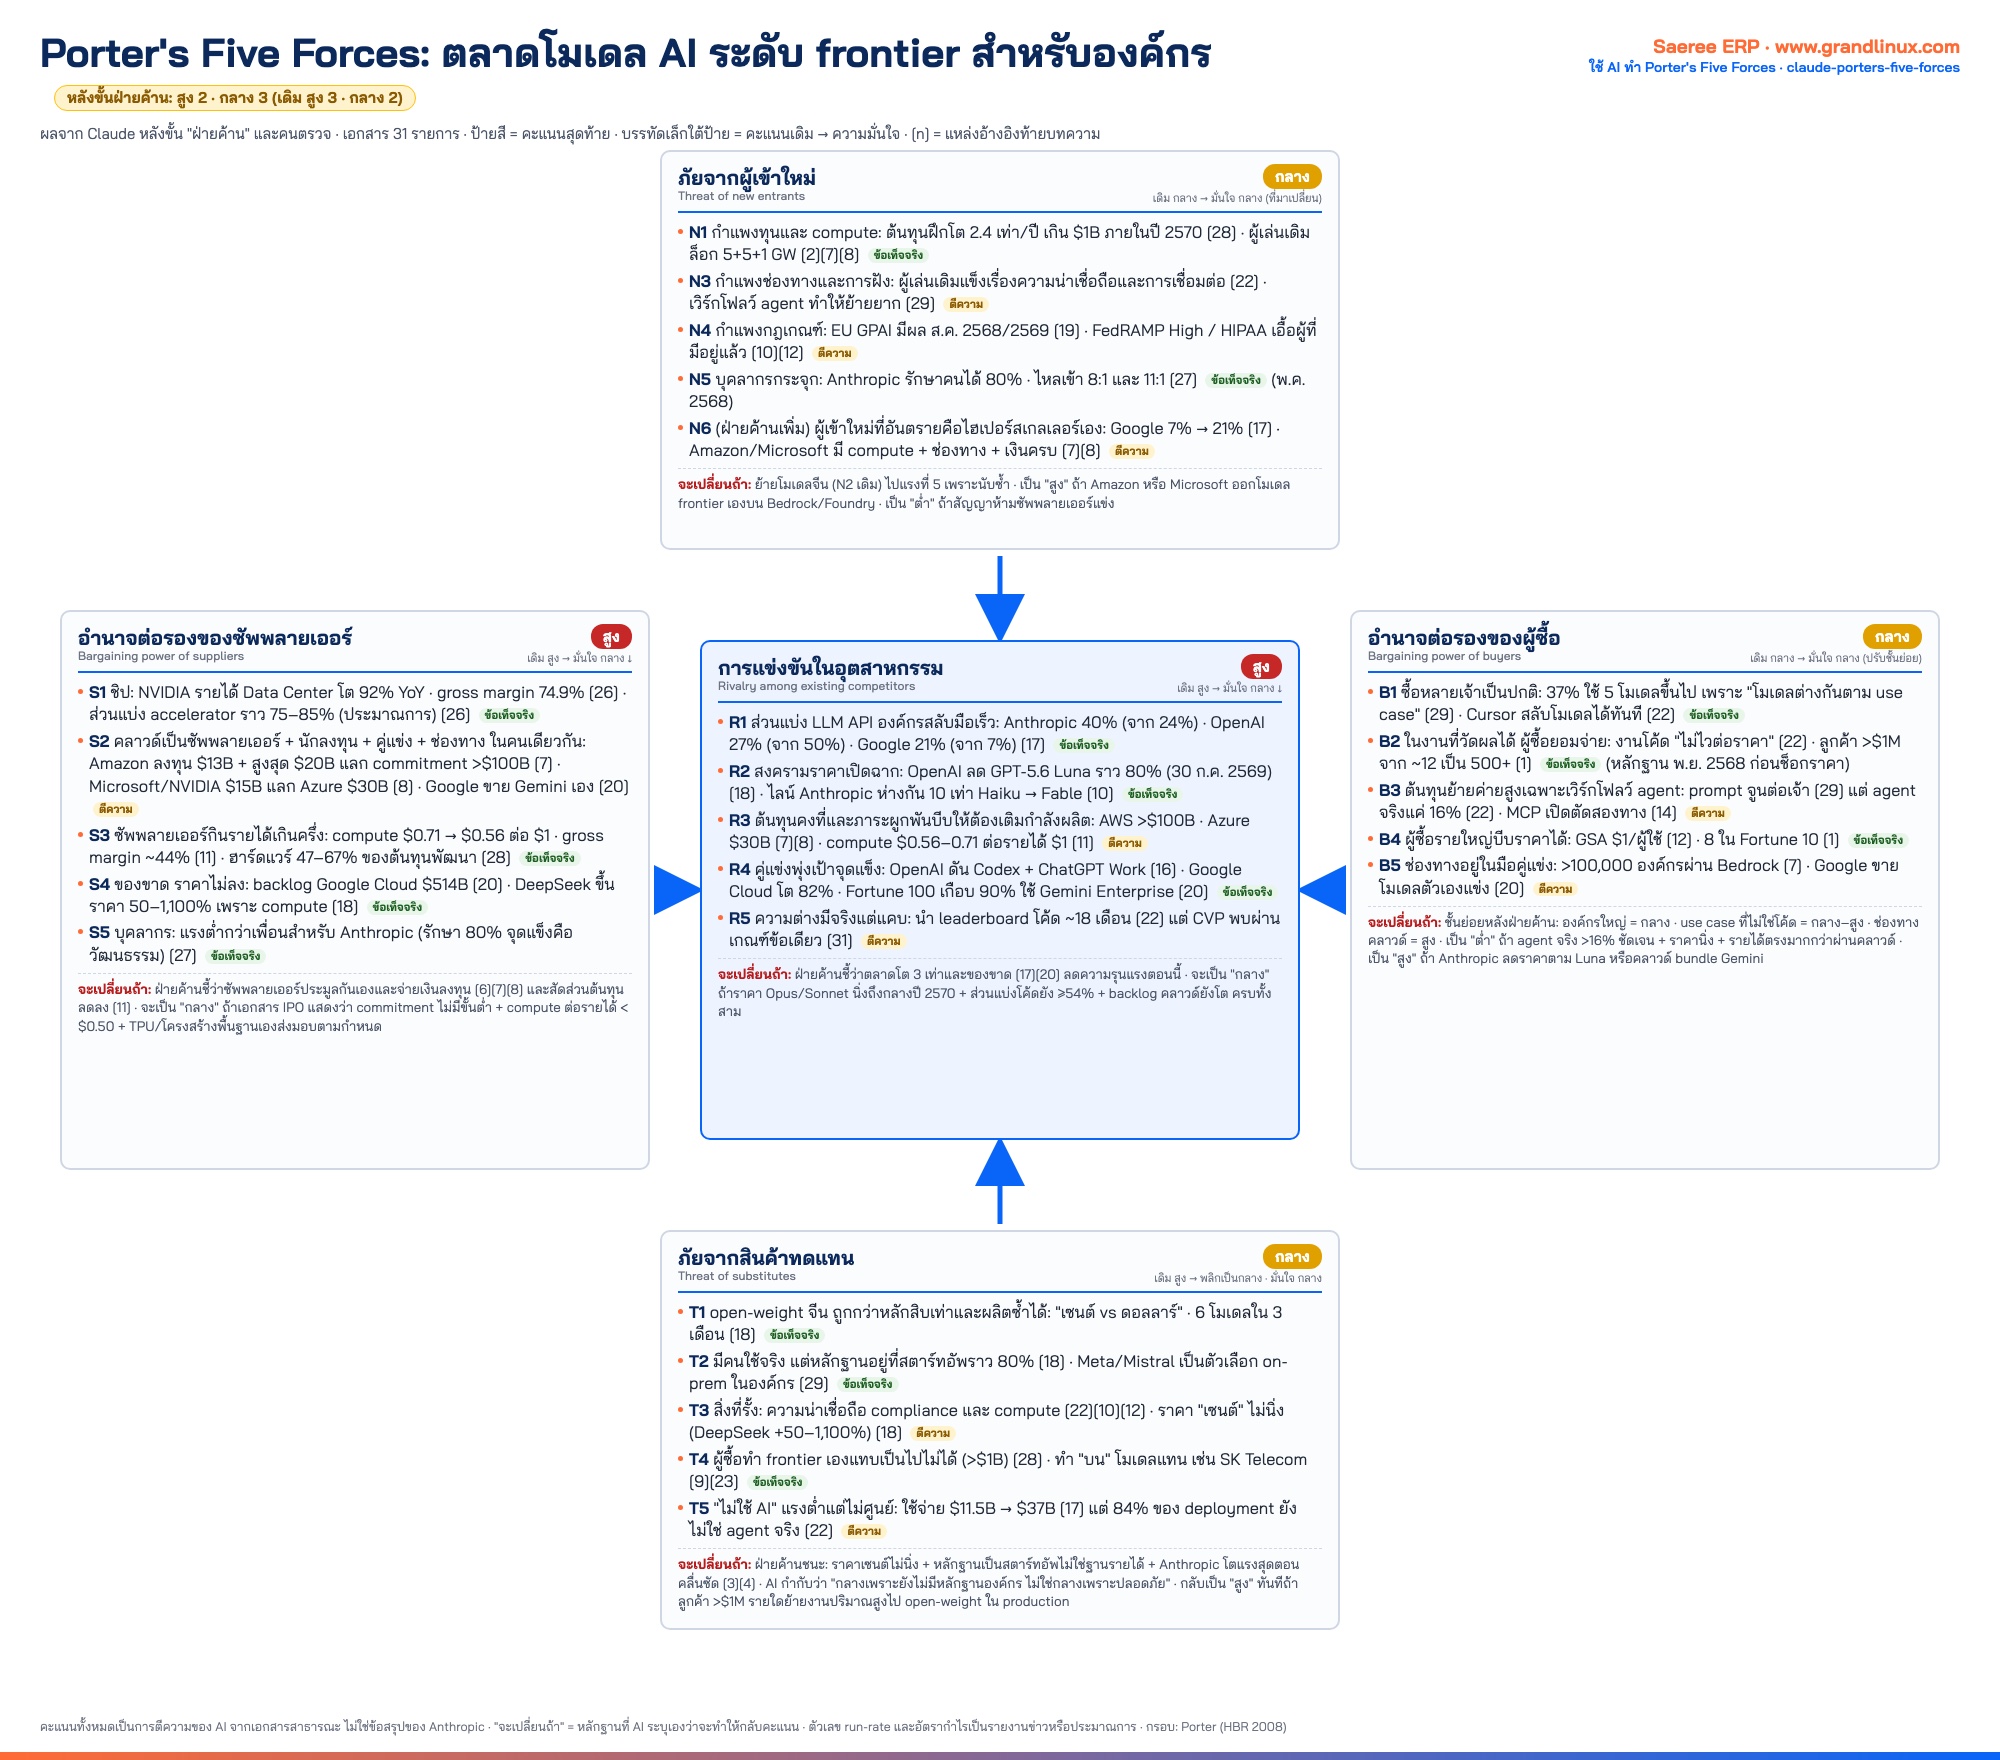
Five Forces ฉบับสุดท้าย สูง 2 แรง กลาง 3 แรง จากเดิมสูง 3 กลาง 2 ข้อ N6 ในกล่องบนคือข้อที่ฝ่ายค้านเพิ่มเข้ามา
กติกาข้อ 3 ให้ AI ตรวจว่าคะแนนสุดท้ายหนุนหรือขัดข้อสรุปของตอนที่ 2 และ 3 ผลคือขัด 2 จุดและหนุนที่เหลือ ซึ่งเป็นสิ่งที่เราอยากเห็น เพราะถ้าหนุนหมดแปลว่ามันแค่เขียนตามของเดิม
| แรง | หนุนข้อสรุปเดิม | ขัดหรือแก้ข้อสรุปเดิม |
|---|---|---|
| การแข่งขัน | ภัย T4 จุดอ่อน W1 กลยุทธ์ WT1 (แยกชั้นราคา) และข้อสรุป CVP ที่ว่าพิสูจน์ความต่างได้เฉพาะงานโค้ด | WT1 มีเวลามากกว่าที่ตอนก่อนบอก ตราบใดที่ของยังขาดทั้งตลาด |
| ผู้เข้าใหม่ | ภัย T2 จุดอ่อน W4 (พึ่งพาคลาวด์) แรงขึ้น และหนุน WO1 (ใช้เงิน IPO ล็อก compute เพื่อยกกำแพง) | ลดการนับซ้ำของภัย T1 ระหว่างแรงที่ 2 กับ 5 |
| ซัพพลายเออร์ | W1, W4, T2, T3 และ WO1 ทั้งหมด | อัตรากำไร 44% ควรอธิบายด้วยแรงนี้แรงเดียว ภาพรวมเดิม "3 ใน 5 แรงสูง" ผิด |
| ผู้ซื้อ | ST1 (ล็อกเวิร์กโฟลว์) ภัย T6 (ช่องทาง) และข้อสรุป CVP ที่ว่ากลุ่มพนักงานสำนักงานยังพิสูจน์ความต่างไม่ได้ | องค์กรยอมจ่าย premium มากกว่าที่ตอนก่อนกังวล สมมติฐานของ WT1 แข็งขึ้น |
| สินค้าทดแทน | WT1 ยังถูก เพราะชั้นล่างของไลน์ราคายังสูง และหนุน CVP ที่ว่าชั้นบนถูกป้องกันด้วยคุณภาพงานโค้ด | ภัย T1 จาก "ภัยที่เกิดแล้ว" เป็น "ภัยแฝงที่ยังไม่มีหลักฐานองค์กร" ความเร่งด่วนของ WT1 ลดลง WO1 มีน้ำหนักขึ้นแทน |
รหัส W/T/WT/WO/ST อ้างอิงจาก ตอนที่ 2 SWOT และ TOWS · ข้อสรุป CVP จาก ตอนที่ 3
สิ่งที่มีค่าที่สุดในตอนนี้ไม่ใช่คะแนน แต่คือคอลัมน์ "สิ่งที่จะทำให้เปลี่ยนใจ" ทุกแรงมีเงื่อนไขที่ตรวจได้ เช่น การแข่งขันจะลดเป็นกลางถ้าราคา Opus/Sonnet นิ่งถึงกลางปี 2570 บวกส่วนแบ่งงานโค้ดยังไม่ต่ำกว่า 54% บวก backlog คลาวด์ยังโต ครบทั้งสาม ซัพพลายเออร์จะลดเป็นกลางถ้าเอกสาร IPO แสดงว่าภาระผูกพันไม่มีขั้นต่ำและ compute ต่อรายได้ต่ำกว่า $0.50 นี่คือรายการตัวชี้วัดที่คนต้องกลับมาดูทุกไตรมาส และเป็นสิ่งที่ Five Forces ที่ทำมือส่วนใหญ่ไม่มี
5. สิ่งที่คนต้องตัดสินใจ: 9 ประเด็นที่ข้อมูลเพิ่มก็ตอบไม่ได้
ตารางสุดท้ายของขั้นฝ่ายค้านต่างจากตาราง "สิ่งที่ต้องตรวจสอบเพิ่ม" ของขั้นแรก ตารางแรกคือของที่หาข้อมูลมาเติมได้ ตารางนี้คือของที่ต่อให้มีข้อมูลครบก็ยังต้องมีคนเลือก เพราะขึ้นกับมุมมองหรือความเสี่ยงที่รับได้ AI ระบุได้ 9 ประเด็น
| # | ประเด็น | แรง | ถ้ามองแบบหนึ่ง | ถ้ามองอีกแบบ |
|---|---|---|---|---|
| 1 | โมเดลจีนที่ขายผ่าน API เป็น "ผู้เข้าใหม่" หรือ "สินค้าทดแทน" | 2, 5 | ทดแทน: แรงที่ 2 ต่ำ ทางแก้คือ WT1 แยกชั้นราคา | ผู้เข้าใหม่: แรงที่ 2 สูง ทางแก้คือ WO1 ยกกำแพง ผลรวมเท่ากัน แต่คนละกลยุทธ์ |
| 2 | ขอบฟ้าเวลา 12 เดือน หรือ 3–5 ปี | 1, 3 | 12 เดือน: ของขาดคุมสงครามราคา แรงที่ 1 เป็นกลางได้ | 3–5 ปี: ซัพพลายไล่ทัน กำลังผลิตที่ผูกพันไว้กลับมาบีบ แรงที่ 1 สูง |
| 3 | ถ่วงน้ำหนักด้วยรายได้ หรือด้วยกรณีเลวร้าย | 5 | ถ่วงด้วยรายได้: สินค้าทดแทนกลาง | มองที่ชั้น Haiku: สูง |
| 4 | หุ้นที่ซัพพลายเออร์ถือคือผลประโยชน์ร่วม หรือการควบคุม | 3 | ร่วม: แรงที่ 3 ลดได้ | ควบคุม: สูงคงที่ การอ่านเจตนาเป็นมุมมอง ข้อมูลช่วยได้บางส่วน |
| 5 | "ความต้องการเกินกำลัง" อ่านเป็นเกราะ หรือเป็นภาระ | 1, 3, 4 | เกราะ: แรงที่ 1 และ 4 ลด | ภาระ: แรงที่ 3 ขึ้น ข้อเท็จจริงเดียวกัน |
| 6 | รับความเสี่ยงแค่ไหนกับ "ยังไม่มีหลักฐานองค์กร ไม่เท่ากับปลอดภัย" | 5 | รอข้อมูล: WT1 ไม่เร่ง รักษากำไรชั้นล่างไว้ก่อน | ไม่รอ: เตรียม WT1 เลย ต้นทุนคือเสียกำไรชั้นล่างก่อนเวลา |
| 7 | หน่วยวิเคราะห์อำนาจผู้ซื้อ: ระดับองค์กร หรือระดับ use case | 4 | องค์กร: ต่ำ–กลาง | use case: กลาง–สูง |
| 8 | ให้น้ำหนัก run-rate แค่ไหน เมื่อวิธีนับยังไม่ยืนยัน | 1, 4, 5 | เชื่อ: ข้อโต้แย้งฝ่ายค้านแรงขึ้นทั้งสามแรง | ไม่เชื่อจนเห็นเอกสาร IPO: คะแนนเดิมยืน |
| 9 | MCP และมาตรฐานเปิดเป็นอาวุธโจมตี หรือจุดรั่ว | 4 | โจมตี: เปิดต่อ ลดต้นทุนย้ายเข้า | ป้องกัน: ล็อกผ่านเครื่องมือของตัวเอง เป็นการเลือกท่าที ไม่ใช่ข้อมูล |
ประเด็นที่ 1 และ 2 คือสิ่งที่ Porter เขียนไว้เองว่าเป็นต้นตอของการวิเคราะห์ที่ผิด (กำหนดอุตสาหกรรมกว้างหรือแคบเกินไป และดูภาพนิ่งแทนแนวโน้ม) AI ไปเจอทั้งสองข้อจากการเถียงตัวเอง ไม่ใช่จากการอ่านกรอบ · MCP = Model Context Protocol มาตรฐานเปิดสำหรับเชื่อมโมเดลกับข้อมูลและเครื่องมือ
6. สิ่งที่เรียนรู้: ขั้นฝ่ายค้านคือส่วนที่ทำให้ผลของ AI ตรวจได้
สรุปจากสี่ตอน AI ไปได้ 5 ขั้น จัดข้อมูล แยกข้อเท็จจริงจากความเห็น จับคู่เป็นทางเลือก ตั้งสมมติฐานเรื่องลูกค้า และตอนนี้คือให้คะแนนแล้วหักล้างคะแนนตัวเองด้วยเอกสารชุดเดิม ขั้นสุดท้ายนี้ต่างจากขั้นอื่นตรงที่มันไม่ได้เพิ่มข้อมูล แต่เพิ่มความรู้ว่าข้อมูลที่มีรองรับข้อสรุปแค่ไหน
- ที่ AI ทำได้ดีกว่าที่คาด จับการนับซ้ำของตัวเองได้ แยกว่าข้อไหนเป็นข้อเท็จจริง ข้อไหนเป็นการกำหนดขอบเขต (โมเดลจีนเป็นผู้เข้าใหม่หรือสินค้าทดแทน "ไม่ใช่ข้อเท็จจริง") ยอมพลิกคะแนนเมื่อแพ้ และกำกับคำตัดสินที่พลิกด้วยประโยคที่กันไม่ให้คนอ่านสบายใจเกินไป
- ที่ต้องเป็นคน ตอบ 9 ประเด็นในตารางที่ 5 ซึ่งเป็นเรื่องมุมมองและความเสี่ยงที่รับได้ เติมข้อมูลภายในที่เอกสารสาธารณะไม่มี (สัดส่วนรายได้ผ่านช่องทาง เงื่อนไขภาระผูกพัน แนวโน้มราคาต่อหน่วย) และรับผิดชอบคะแนนที่จะเอาไปใช้ตัดสินใจลงทุน
- ที่ต้องระวังเป็นพิเศษ ขั้นที่ 1 อ่านลื่นกว่าขั้นที่ 2 เสมอ เพราะขั้นที่ 2 เต็มไปด้วยเงื่อนไข ถ้าเอาไปนำเสนอผู้บริหาร คนมักเลือกขั้นที่ 1 ให้เลือกขั้นที่ 2 แล้วนำเสนอด้วยคอลัมน์ "สิ่งที่จะทำให้เปลี่ยนใจ" เป็นหลัก
7. เอาไปใช้กับบริษัทตัวเอง: แรงซัพพลายเออร์และผู้ซื้อของคุณอยู่ในระบบอยู่แล้ว
Five Forces ของบริษัทใหญ่ในข่าวต้องพึ่งรายงานนักวิเคราะห์ แต่สองใน 5 แรงของบริษัทคุณเอง คืออำนาจต่อรองของซัพพลายเออร์และของผู้ซื้อ มีหลักฐานอยู่ในระบบ ERP (Enterprise Resource Planning) อยู่แล้ว และเป็นหลักฐานที่ดีกว่าข่าว เพราะเป็นตัวเลขจริงของคุณ
- กำหนดขอบเขตให้แคบและเขียนลงกระดาษก่อน ประเด็นที่ 1 และ 2 ในตารางที่ 5 คือจุดที่การวิเคราะห์ส่วนใหญ่พังตั้งแต่ต้น ระบุว่าอุตสาหกรรมคืออะไร ขายให้ใคร ในพื้นที่ไหน มองไป 12 เดือนหรือ 3–5 ปี แล้วใส่ไว้ในคำสั่งบรรทัดแรก ถ้าไม่ระบุ AI จะกำหนดเอง และคุณจะเถียงกับคะแนนโดยไม่รู้ว่าเถียงเรื่องขอบเขต
- ดึงแรงซัพพลายเออร์และผู้ซื้อจากระบบ ส่งออกประวัติการจัดซื้อแยกตามซัพพลายเออร์ย้อนหลัง 2–3 ปี จะเห็นทันทีว่ามูลค่าซื้อกระจุกที่กี่ราย ราคาต่อหน่วยของวัตถุดิบหลักขึ้นกี่ครั้ง และมีซัพพลายเออร์สำรองไหม ฝั่งผู้ซื้อส่งออกยอดขายและลูกหนี้แยกตามลูกค้า จะเห็นว่าลูกค้า 5 อันดับแรกเป็นกี่เปอร์เซ็นต์ของรายได้ และรายไหนต่อรองส่วนลดหรือยืดเครดิตได้ ใส่วันที่ทุกไฟล์ เรื่องการอ่านข้อมูลจัดซื้ออ่านที่ ระบบจัดซื้อใน ERP
- เอกสารสาธารณะสำหรับอีก 3 แรง การแข่งขัน ผู้เข้าใหม่ และสินค้าทดแทน ใช้ข่าวอุตสาหกรรม รายงานสมาคม และราคาของคู่แข่งที่ประกาศ ทำเป็นเอกสารแนบใส่เลขและวันที่เหมือนที่เราทำ ข้อไหนไม่มีเอกสารให้ AI กำกับว่า "ความรู้เดิม" วิธีแนบไฟล์และให้ทีมใช้เอกสารชุดเดียวกันอ่านที่ ใช้ Claude อ่านไฟล์ Excel, CSV, PDF และ Claude Projects
- รันสองขั้นเสมอ และอย่าข้ามขั้นฝ่ายค้าน ใช้คำสั่งขั้นที่ 1 แล้วต่อด้วยขั้นที่ 2 ทันที กติกา "ห้ามเพิ่มข้อเท็จจริงใหม่" ต้องอยู่ ถ้าฝ่ายค้านพลิกคะแนนได้ด้วยเอกสารชุดเดิม แปลว่าคะแนนนั้นไม่ควรเอาไปใช้จนกว่าจะหาข้อมูลเพิ่ม
- เอาคอลัมน์ "สิ่งที่จะทำให้เปลี่ยนใจ" ไปทำเป็นตัวชี้วัดรายไตรมาส เช่น สัดส่วนซื้อจากซัพพลายเออร์รายใหญ่สุด สัดส่วนรายได้จากลูกค้า 5 อันดับแรก จำนวนครั้งที่ต้องลดราคาสู้คู่แข่ง ดูจากระบบทุกไตรมาส เมื่อตัวเลขข้ามเส้นที่ AI เขียนไว้ ค่อยกลับมาให้คะแนนใหม่ นี่คือการเปลี่ยน Five Forces จากเอกสารครั้งเดียวเป็นเครื่องมือบริหารความเสี่ยง อ่านต่อที่ การบริหารความเสี่ยงองค์กร และเรื่องบทบาทผู้บริหารกับการตัดสินใจบนข้อมูลจริงที่ ERP สำเร็จหรือล้มอยู่ที่ผู้บริหาร
จากงานของเรา: ลูกค้า Saeree ERP ดึงประวัติการจัดซื้อแยกตามซัพพลายเออร์ ยอดขายและลูกหนี้แยกตามลูกค้า และรายงานราคาซื้อของวัตถุดิบหลัก เป็น Excel หรือ PDF แล้วแนบให้ Claude ทำแรงซัพพลายเออร์และแรงผู้ซื้อได้ตามขั้นตอนข้างต้น องค์กรที่ต้องการให้ Claude ถามตัวเลขเหล่านี้จาก ERP ได้โดยตรงทุกไตรมาส เราเชื่อมผ่าน MCP แบบกำหนดสิทธิ์ตามบทบาทและเก็บบันทึกทุกคำถาม ระบบ ERP ยังเป็นแหล่งข้อมูลจริง Claude เป็นผู้ให้คะแนนและฝ่ายค้าน ส่วนคนเป็นผู้ตัดสิน ดูรูปแบบงานที่ Claude Solutions และแนวคิดที่ MCP คืออะไร
อ่านย้อนหลังทั้งชุด: ตอนที่ 1 Business Model Canvas · ตอนที่ 2 SWOT และ TOWS Matrix · ตอนที่ 3 Customer Value Proposition · ตอนที่ 4 บทความนี้ ทั้งสี่ตอนใช้เอกสารชุดเดียวกันที่ขยายขึ้นเรื่อย ๆ จาก 21 เป็น 31 รายการ
สรุป
- AI ให้คะแนน Porter's Five Forces ครบ 5 แรง พร้อมปัจจัย 25 ข้อที่มีเลขอ้างอิงและป้ายข้อเท็จจริงหรือตีความ ในเวลาไม่ถึง 10 นาที ขั้นแรกได้สูง 3 กลาง 2
- เมื่อสั่งให้เถียงตัวเองด้วยเอกสารชุดเดิม สินค้าทดแทนพลิกจากสูงเป็นกลาง ความมั่นใจของการแข่งขันและซัพพลายเออร์ลดลง และ AI จับได้เองว่านับโมเดลจีนซ้ำสองแรง
- ข้อสรุปที่เปลี่ยนคือคำอธิบายอัตรากำไร 44% ไม่ได้มาจาก "3 ใน 5 แรงสูง" แต่มาจากซัพพลายเออร์ที่เป็นผู้ถือหุ้น คู่แข่ง และช่องทางพร้อมกัน แรงเดียว
- ของที่มีค่าที่สุดคือ "สิ่งที่จะทำให้เปลี่ยนใจ" ของทุกแรง และตาราง 9 ประเด็นที่ต่อให้มีข้อมูลครบก็ยังต้องมีคนตัดสินใจ
- สำหรับบริษัทของคุณ แรงซัพพลายเออร์และแรงผู้ซื้ออยู่ในระบบ ERP อยู่แล้ว ดึงออกมาใส่วันที่ รันสองขั้น แล้วเอาเงื่อนไขเปลี่ยนใจไปเป็นตัวชี้วัดรายไตรมาส
คะแนน Five Forces ที่ AI ให้ครั้งแรกอ่านลื่นและมั่นใจ แต่ครั้งที่สองที่มันเถียงตัวเอง ทำให้รู้ว่าคะแนนไหนยืนบนข้อเท็จจริง คะแนนไหนยืนบนการกำหนดขอบเขต สิ่งที่ควรเก็บไว้ใช้จึงไม่ใช่คะแนน แต่คือเงื่อนไขที่บอกว่าเมื่อไรคะแนนจะเปลี่ยน
- ข้อสรุปจากการทดลองตอนที่ 4 26 กันยายน 2569
แหล่งอ้างอิง
- [1] Anthropic: Anthropic raises $30B Series G at $380B post-money valuation (12 ก.พ. 2569)
- [2] Anthropic: Anthropic raises $65B Series H at $965B valuation (28 พ.ค. 2569)
- [3] TechCrunch (อ้าง Bloomberg): Anthropic's annualized revenue surges to $65B (17 ส.ค. 2569)
- [4] Axios (อ้าง The New York Times): Anthropic tops $100 billion revenue pace, report says (18 ก.ย. 2569)
- [5] Anthropic: Expanding our use of Google Cloud TPUs and services (23 ต.ค. 2568)
- [6] Anthropic: Anthropic expands Google and Broadcom compute deal (6 เม.ย. 2569)
- [7] Amazon: Amazon announces $5B Anthropic investment, up to $20B more (20 เม.ย. 2569)
- [8] Microsoft: Microsoft, NVIDIA and Anthropic announce strategic partnerships (18 พ.ย. 2568)
- [9] Anthropic: Seoul becomes third Anthropic office in Asia-Pacific (และ Sydney fourth office, 10 มี.ค. 2569) (23 ต.ค. 2568)
- [10] Claude: Pricing page (ตรวจ 26 ก.ย. 2569)
- [11] Yahoo Finance: Anthropic's gross margin is the most important number in tech (10 มิ.ย. 2569)
- [12] GSA: GSA strikes another OneGov deal with Anthropic (ขยายถึง 31 ต.ค. 2569 ตามรายงาน Nextgov ก.ย. 2569) (12 ส.ค. 2568)
- [13] Anthropic: The Long-Term Benefit Trust (ก.ย. 2566)
- [14] Anthropic: Claude Cowork และหน้าผลิตภัณฑ์ที่ claude.com (ตรวจ 26 ก.ย. 2569)
- [15] Sacra: Anthropic revenue, valuation & funding (ประมาณการบุคคลที่สาม) (2569)
- [16] Yahoo Finance / Quartz (อ้าง Bloomberg): OpenAI annualized revenue tops $40 billion ahead of IPO (14 ส.ค. 2569)
- [17] Menlo Ventures: 2025 — The State of Generative AI in the Enterprise (9 ธ.ค. 2568)
- [18] State Street Investment Management: Beyond DeepSeek — China's 2026 model wave and the repricing of the AI stack (21 ก.ย. 2569)
- [19] EU Artificial Intelligence Act: Implementation timeline (อัปเดต 31 ส.ค. 2569)
- [20] PYMNTS: Google Cloud rides enterprise AI demand to 82% growth (ผลประกอบการ Alphabet Q2/2569) (22 ก.ค. 2569)
- [21] บทความตอนที่ 1 ของเรา: ใช้ AI เขียน Business Model Canvas ได้แค่ไหน? — BMC ที่ตรวจแล้ว (26 ก.ย. 2569)
- [22] Menlo Ventures (รายงานเดียวกับ [17]) ส่วนที่ว่าด้วยเหตุผลที่องค์กรเลือกผู้ขายและความไวต่อราคา (9 ธ.ค. 2568)
- [23] Claude: Customer stories (ตรวจ 26 ก.ย. 2569)
- [24] Anthropic Economic Index: Economic primitives (15 ม.ค. 2569) และ Cadences (26 มิ.ย. 2569)
- [25] บทความตอนที่ 2 ของเรา: ใช้ AI ทำ SWOT และ TOWS Matrix ได้แค่ไหน? (26 ก.ย. 2569)
- [26] NVIDIA: Financial results for first quarter fiscal 2027 (ไตรมาสสิ้นสุด 26 เม.ย. 2569) (20 พ.ค. 2569)
- [27] SignalFire: State of Tech Talent Report 2025 (20 พ.ค. 2568)
- [28] Epoch AI: How much does it cost to train frontier AI models? (3 มิ.ย. 2567)
- [29] Andreessen Horowitz: How 100 Enterprise CIOs Are Building and Buying Gen AI in 2025 (10 มิ.ย. 2568)
- [30] Porter, M. E. (2008): The Five Competitive Forces That Shape Strategy, Harvard Business Review (ม.ค. 2551)
- [31] บทความตอนที่ 3 ของเรา: ใช้ AI ทำ Customer Value Proposition (CVP) ได้แค่ไหน? — สรุปข้อสรุปตอน 1–3 ใช้เป็นเอกสารแนบรายการที่ 31 (26 ก.ย. 2569)
อยากทำ Five Forces ของอุตสาหกรรมคุณจากข้อมูลซัพพลายเออร์และลูกค้าจริงในระบบ?
บริการจัดหา Claude Team และ Enterprise พร้อมใบเสนอราคาเป็นเงินบาทและใบกำกับภาษี รับตั้งแต่ 5 ที่นั่ง และงานเชื่อม Claude กับข้อมูลจัดซื้อ ลูกหนี้ และยอดขายใน ERP ผ่าน MCP แบบกำหนดสิทธิ์ตามบทบาท
ปรึกษา / ขอใบเสนอราคาโทร 02-347-7730 | sale@grandlinux.com