- 26
- กันยายน
"ใช้ AI ทำ Customer Value Proposition (CVP) ได้แค่ไหน? ตอนที่ 3 กับ Anthropic จาก Value Proposition Canvas สู่จุดขายที่ลูกค้าจ่ายจริง" — คำตอบสั้นที่สุดคือ ไปได้ถึงขั้น "ตั้งสมมติฐานเรื่องลูกค้าพร้อมวิธีทดสอบ" แต่ไม่ถึงขั้น "รู้ใจลูกค้า" ถ้าบังคับให้ติดป้ายที่มา Claude จะยอมรับเองว่าฝั่งลูกค้า 36 ข้อมาจากลูกค้าจริงแค่ 12 ข้อ ที่เหลือคือมุมผู้ขาย และเมื่อสอบด้วยกรอบ CVP ของ HBR ข้อเสนอที่ผ่านเกณฑ์ "ต่าง วัดได้ มีหลักฐาน" ครบ มีข้อเดียว บทความนี้เป็นตอนที่ 3 ต่อจาก Business Model Canvas และ SWOT/TOWS ทดลองจริงกับ Anthropic ด้วยเอกสาร 25 รายการ เอาผลมาให้ดูทั้งภาพและตาราง แล้วสรุปเป็นวิธีเอาไปใช้กับบริษัทของคุณเอง
สรุปสั้นๆ: AI ทำ Value Proposition Canvas ให้ลูกค้า 3 กลุ่มของ Anthropic และติดป้ายเองว่าฝั่งลูกค้า 36 ข้อ มาจากลูกค้าจริง 12 มุมผู้ขาย 22 ความรู้เดิม 2 เมื่อสอบด้วยกรอบ CVP ของ HBR ข้อเสนอที่ผ่านเกณฑ์ครบมีข้อเดียวคือคุณภาพงานโค้ด และ AI ให้คำถาม 39 ข้อสำหรับถามลูกค้าจริง
หมายเหตุก่อนอ่าน: บทความนี้เป็นตอนที่ 3 ต่อจาก Business Model Canvas และ SWOT และ TOWS ทดลองวันที่ 26 กันยายน 2569 ด้วย Claude (โมเดล Claude Fable 5.1 ผ่าน Claude Code) ปิดการค้นเว็บ ให้ AI ตอบจากเอกสารแนบ 25 รายการเท่านั้น งานเรื่องคุณค่าต่อลูกค้ามีความเห็นปนอยู่โดยธรรมชาติ เราคงป้ายที่มาของทุกข้อไว้ตามที่ AI ระบุเอง ตัวเลขผลลัพธ์ของลูกค้า Anthropic มาจากหน้าเรื่องราวลูกค้าของผู้ขาย ไม่มีวิธีวัดกำกับ ราคาเป็นดอลลาร์สหรัฐ ไม่แปลงเป็นบาท และขอแจ้งให้ชัดเหมือนสองตอนแรก บริษัทเราจำหน่ายและจัดหา Claude ให้องค์กรไทย แต่เขียนจากข้อมูลสาธารณะเท่านั้น
ตอนที่แล้ว AI เลือกกลยุทธ์ 3 อันดับแรกให้ Anthropic และทั้ง 3 ข้อตั้งอยู่บนสมมติฐานเดียวกันคือ "ลูกค้ายอมจ่ายเพื่อคุณภาพ" ตอนนี้เราไปทดสอบสมมติฐานนั้นจากฝั่งลูกค้า ด้วยเครื่องมือที่ที่ปรึกษาใช้ตอบคำถามว่า ลูกค้าซื้อเพราะอะไรกันแน่ นั่นคือ Customer Value Proposition (CVP) หรือข้อเสนอคุณค่าต่อลูกค้า และเป็นตอนที่ AI ต้องเจอกับข้อจำกัดที่ใหญ่ที่สุดของมัน คือมันไม่เคยคุยกับลูกค้า
1. Customer Value Proposition คืออะไร และทำไมถึงเป็นข้อสอบที่ยากที่สุดสำหรับ AI
เราใช้เครื่องมือสองชิ้นต่อกัน ชิ้นแรกคือ Value Proposition Canvas (VPC) ของ Osterwalder และคณะ (ปี 2557) ซึ่งเป็นการซูมเข้าไปในช่อง "คุณค่าที่ส่งมอบ" ของ Business Model Canvas ตอนที่ 1 มีสองฝั่ง ฝั่งลูกค้าคือ งานที่ลูกค้าต้องทำให้เสร็จ (jobs) ความเจ็บปวดระหว่างทำ (pains) และสิ่งที่อยากได้ (gains) ฝั่งข้อเสนอคือ ผลิตภัณฑ์ ตัวบรรเทาความเจ็บปวด (pain relievers) และตัวสร้างประโยชน์ (gain creators) ถ้าสองฝั่งจับคู่กันได้เรียกว่า "fit" ถ้าฝั่งลูกค้ามีความเจ็บปวดที่ไม่มีอะไรบรรเทา นั่นคือช่องว่าง
ชิ้นที่สองคือกรอบ Customer Value Proposition ของ Anderson, Narus และ van Rossum ใน Harvard Business Review (ปี 2549) ที่บอกว่าข้อเสนอคุณค่ามี 3 แบบ และแบบที่ใช้ได้จริงมีแบบเดียว
| แบบ | ตอบคำถามว่า | จุดอ่อน | ต้องมีอะไรถึงจะเขียนได้ |
|---|---|---|---|
| All benefits ยกประโยชน์ทั้งหมด | เราให้อะไรลูกค้าได้บ้าง | ยาว และไม่ต่างจากคู่แข่ง | รู้แค่สินค้าตัวเอง |
| Favorable points of difference ความต่างที่ได้เปรียบ | เราต่างจากทางเลือกถัดไปตรงไหน | ต่างจริง แต่ลูกค้าอาจไม่แคร์ | รู้สินค้าตัวเองและคู่แข่ง |
| Resonating focus จุดที่โดนใจที่สุด | ความต่าง 1–2 ข้อไหนที่ลูกค้าให้น้ำหนักที่สุด และพิสูจน์ได้ | เขียนยากที่สุด | รู้สินค้าตัวเอง คู่แข่ง และเข้าใจลูกค้าจริง พร้อมหลักฐานที่ลูกค้าตรวจได้ |
บรรทัดสุดท้ายของตารางคือเหตุผลที่ตอนนี้เป็นข้อสอบยากสำหรับ AI ตอนที่ 1 และ 2 ทำจากเอกสารสาธารณะได้ เพราะเป็นเรื่องของบริษัท แต่ฝั่งลูกค้าของ VPC ต้องมาจากปากลูกค้า ซึ่งเอกสารสาธารณะแทบไม่มี สิ่งที่มีคือหน้าเรื่องราวลูกค้าที่ผู้ขายเลือกเผยแพร่เอง คำถามของเราจึงไม่ใช่แค่ AI ทำได้ไหม แต่คือ AI รู้ตัวไหมว่ากำลังมองลูกค้าผ่านสายตาผู้ขาย
หลักที่ใช้ตอนนี้: บังคับให้ AI ติดป้ายที่มาของทุกข้อฝั่งลูกค้าว่ามาจากลูกค้าจริง จากมุมผู้ขายหรือนักวิเคราะห์ หรือจากความรู้เดิม และให้เขียนคำถามที่ต้องเอาไปถามลูกค้าจริงแนบมาด้วย ถ้าไม่มีสองอย่างนี้ VPC ที่ AI เขียนจะดูเหมือนมาจากลูกค้าทั้งหมด ทั้งที่ไม่ใช่
ใช้ Claude ในองค์กร? ขอใบเสนอราคาเป็นเงินบาท พร้อมใบกำกับภาษี
บริการจัดหาของเรารับตั้งแต่ 5 ที่นั่ง · น้อยกว่านั้นแนะนำซื้อตรงจาก Anthropic · Enterprise ปรึกษาทีมขาย
2. วิธีทดลอง: ทำ Value Proposition Canvas ก่อน แล้วเอาไปสอบด้วยกรอบของ HBR
สองขั้นเหมือนตอนที่แล้ว ขั้นแรกทำ VPC ให้ลูกค้า 3 กลุ่มที่ได้จาก BMC ตอนที่ 1 คือ A องค์กรใหญ่ในอุตสาหกรรมกำกับเข้ม B ทีมวิศวกรรมซอฟต์แวร์ และ C พนักงานสำนักงานทั่วไป ขั้นที่สองเอา VPC ที่ได้ไปสอบด้วยกรอบของ HBR โดยเทียบกับทางเลือกถัดไปที่ลูกค้าแต่ละกลุ่มน่าจะพิจารณา เอกสารแนบ 25 รายการคือ 21 รายการจากตอนที่แล้ว บวก 4 รายการที่งานนี้ต้องมี ได้แก่ ส่วนของรายงาน Menlo Ventures ที่พูดถึงเหตุผลที่องค์กรเลือกผู้ขาย หน้าเรื่องราวลูกค้าของ Anthropic รายงาน Anthropic Economic Index ที่บอกว่าคนใช้ Claude ทำงานอะไรจริง และสรุป SWOT/TOWS ตอนที่ 2
คุณเป็นที่ปรึกษากลยุทธ์ธุรกิจ ช่วยทำ Customer Value Proposition ของ Anthropic
(ผู้พัฒนา Claude) ด้วย Value Proposition Canvas จากเอกสารแนบ สำหรับลูกค้า 3 กลุ่ม
A. องค์กรใหญ่ในอุตสาหกรรมกำกับเข้ม (การเงิน สุขภาพ ภาครัฐ)
B. ทีมวิศวกรรมซอฟต์แวร์และนักพัฒนา
C. พนักงานสำนักงานทั่วไปในองค์กร (งานเอกสาร วิเคราะห์ เวิร์กโฟลว์)

กติกา
1. ตอบเป็นภาษาไทย ภาษาคนทำงาน ไม่ต้องเกริ่น
2. แต่ละกลุ่มทำ 2 ฝั่ง ฝั่งลูกค้า: งานที่ต้องทำให้เสร็จ (jobs) · ความเจ็บปวด (pains) ·
   สิ่งที่อยากได้ (gains) ฝั่งข้อเสนอ: ผลิตภัณฑ์และบริการ · ตัวบรรเทาความเจ็บปวด ·
   ตัวสร้างประโยชน์ อย่างละ 3–4 ข้อ ตั้งรหัส A-J1, A-P1, A-G1, A-PR1, A-GC1 ...
3. ทุกข้อฝั่งข้อเสนอต้องอ้าง [n] จากเอกสารแนบ ทุกข้อฝั่งลูกค้าให้ระบุที่มาเป็นหนึ่งใน
   (ก) มีหลักฐานจากลูกค้าจริงในเอกสาร [n] (ข) อนุมานจากสิ่งที่ผู้ขายหรือสื่อพูด [n]
   (ค) ความรู้เดิม อาจล้าสมัย
4. ระบุ "fit" ของแต่ละกลุ่ม: pain หรือ gain ข้อไหนที่ยังไม่มีตัวรองรับ (ช่องว่าง)
   และข้อเสนอไหนที่ไม่ตรงกับ pain หรือ gain ใดเลย
5. ห้ามเดาตัวเลข
6. ปิดท้ายด้วยตาราง "สิ่งที่ต้องยืนยันกับลูกค้าจริง" ระบุว่าข้อไหนฝั่งลูกค้ามาจาก
   มุมผู้ขาย และควรถามลูกค้าด้วยคำถามอะไร
7. ไม่ต้องค้นเว็บ
คำสั่งขั้นที่สองแนบ VPC ทั้งฉบับกับเอกสารชุดเดิม แล้วสั่งให้แยก 3 ชั้นต่อกลุ่ม คือ points of parity (สิ่งที่คู่แข่งก็มี) points of difference (ความต่างที่มีหลักฐาน) และ resonating focus (1–2 ข้อที่ลูกค้าน่าจะให้น้ำหนักสุด) ทุกข้ออ้าง [n] และกำกับข้อเท็จจริงหรือตีความ กติกาที่เพิ่มมามี 3 ข้อ หนึ่ง ทุก resonating focus ต้องบอกหลักฐานที่มี หลักฐานที่ยังขาด และ "สิ่งที่ต้องเป็นจริงก่อน" สอง ต้องเชื่อมกับ TOWS ตอนที่แล้วว่าสมมติฐาน "ยอมจ่ายเพื่อคุณภาพ" ของ WT1 และ ST1 ถูกสนับสนุนหรือท้าทาย สาม เขียนประโยคข้อเสนอคุณค่า 1 ประโยคต่อกลุ่ม ในรูป "สำหรับ [ลูกค้า] ที่ [งานหรือปัญหา] Claude คือ [หมวด] ที่ [ความต่างหลัก] เพราะ [หลักฐาน]" และกำกับว่าส่วนไหนของประโยคเป็นการตีความ วิธีเขียนกติกาแบบนี้เราอธิบายไว้ใน คู่มือเขียน prompt ให้ Claude
สองขั้นใช้เวลารวมราว 15 นาที ได้คำตอบขั้นละราว 14,000 และ 17,000 ตัวอักษร ยาวที่สุดในสามตอน เพราะครึ่งหนึ่งเป็นตารางคำถามสำหรับถามลูกค้า
3. ผลขั้นที่ 1: ฝั่งลูกค้า 36 ข้อ AI ยอมรับเองว่ามาจากลูกค้าจริงแค่ 12 ข้อ
นี่คือ VPC ในเลย์เอาต์มาตรฐานของ Strategyzer ทีละกลุ่ม สี่เหลี่ยมซ้ายคือฝั่งข้อเสนอ วงกลมขวาคือฝั่งลูกค้า ลูกศรตรงกลางคือคำถามว่าสองฝั่งจับคู่กันได้ไหม ป้ายสีเขียว "ลูกค้าจริง" สีเหลือง "มุมผู้ขาย" และสีแดง "ความรู้เดิม" เป็นป้ายที่ AI ติดเองตามกติกาข้อ 3 ตัวเลขในป้ายเหลืองบนหัวภาพคือจำนวนแต่ละแบบของกลุ่มนั้น คลิกที่ภาพเพื่อเปิดขนาดเต็ม
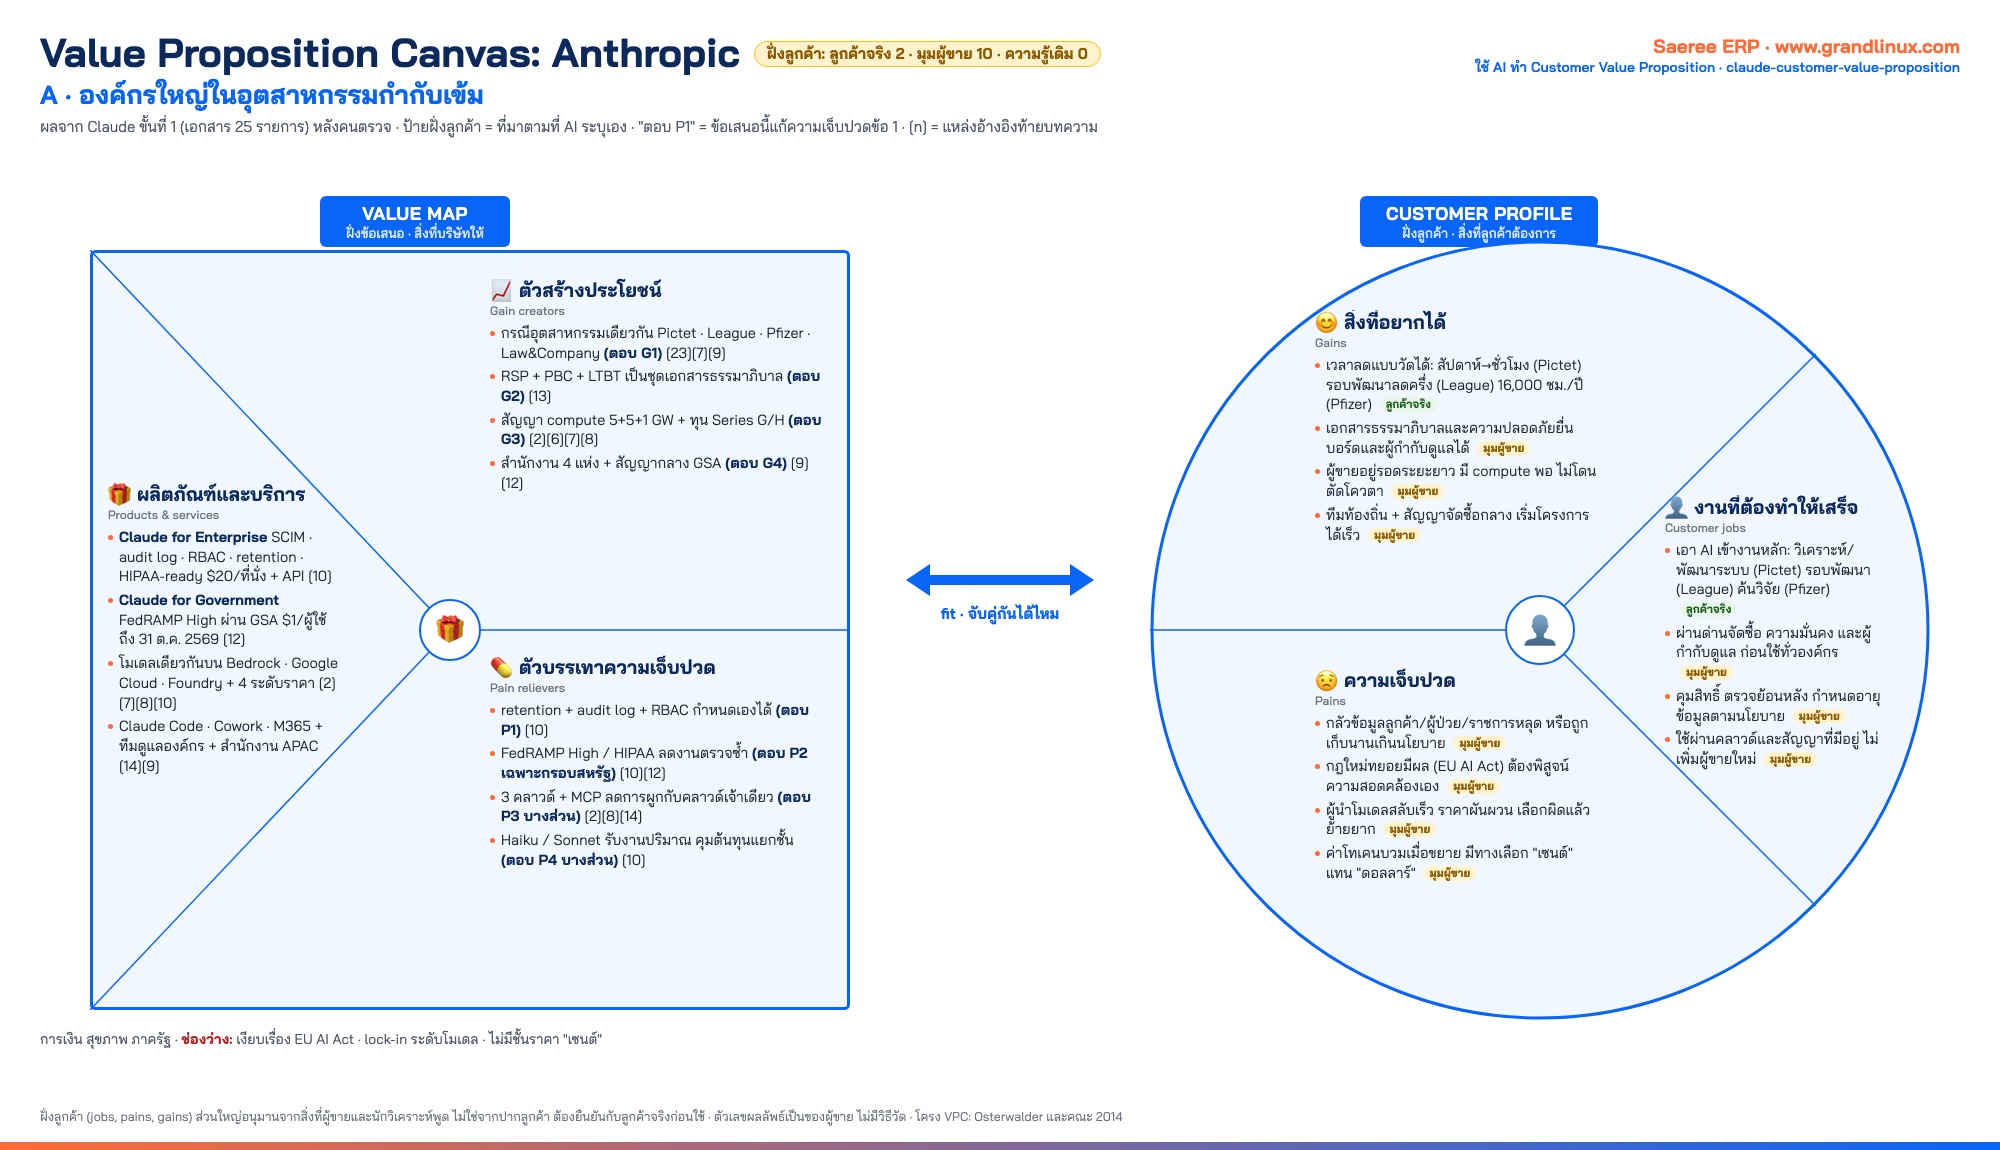
กลุ่ม A องค์กรใหญ่ในอุตสาหกรรมกำกับเข้ม ฝั่งลูกค้ามาจากลูกค้าจริงแค่ 2 ใน 12 ข้อ น้อยที่สุดในสามกลุ่ม
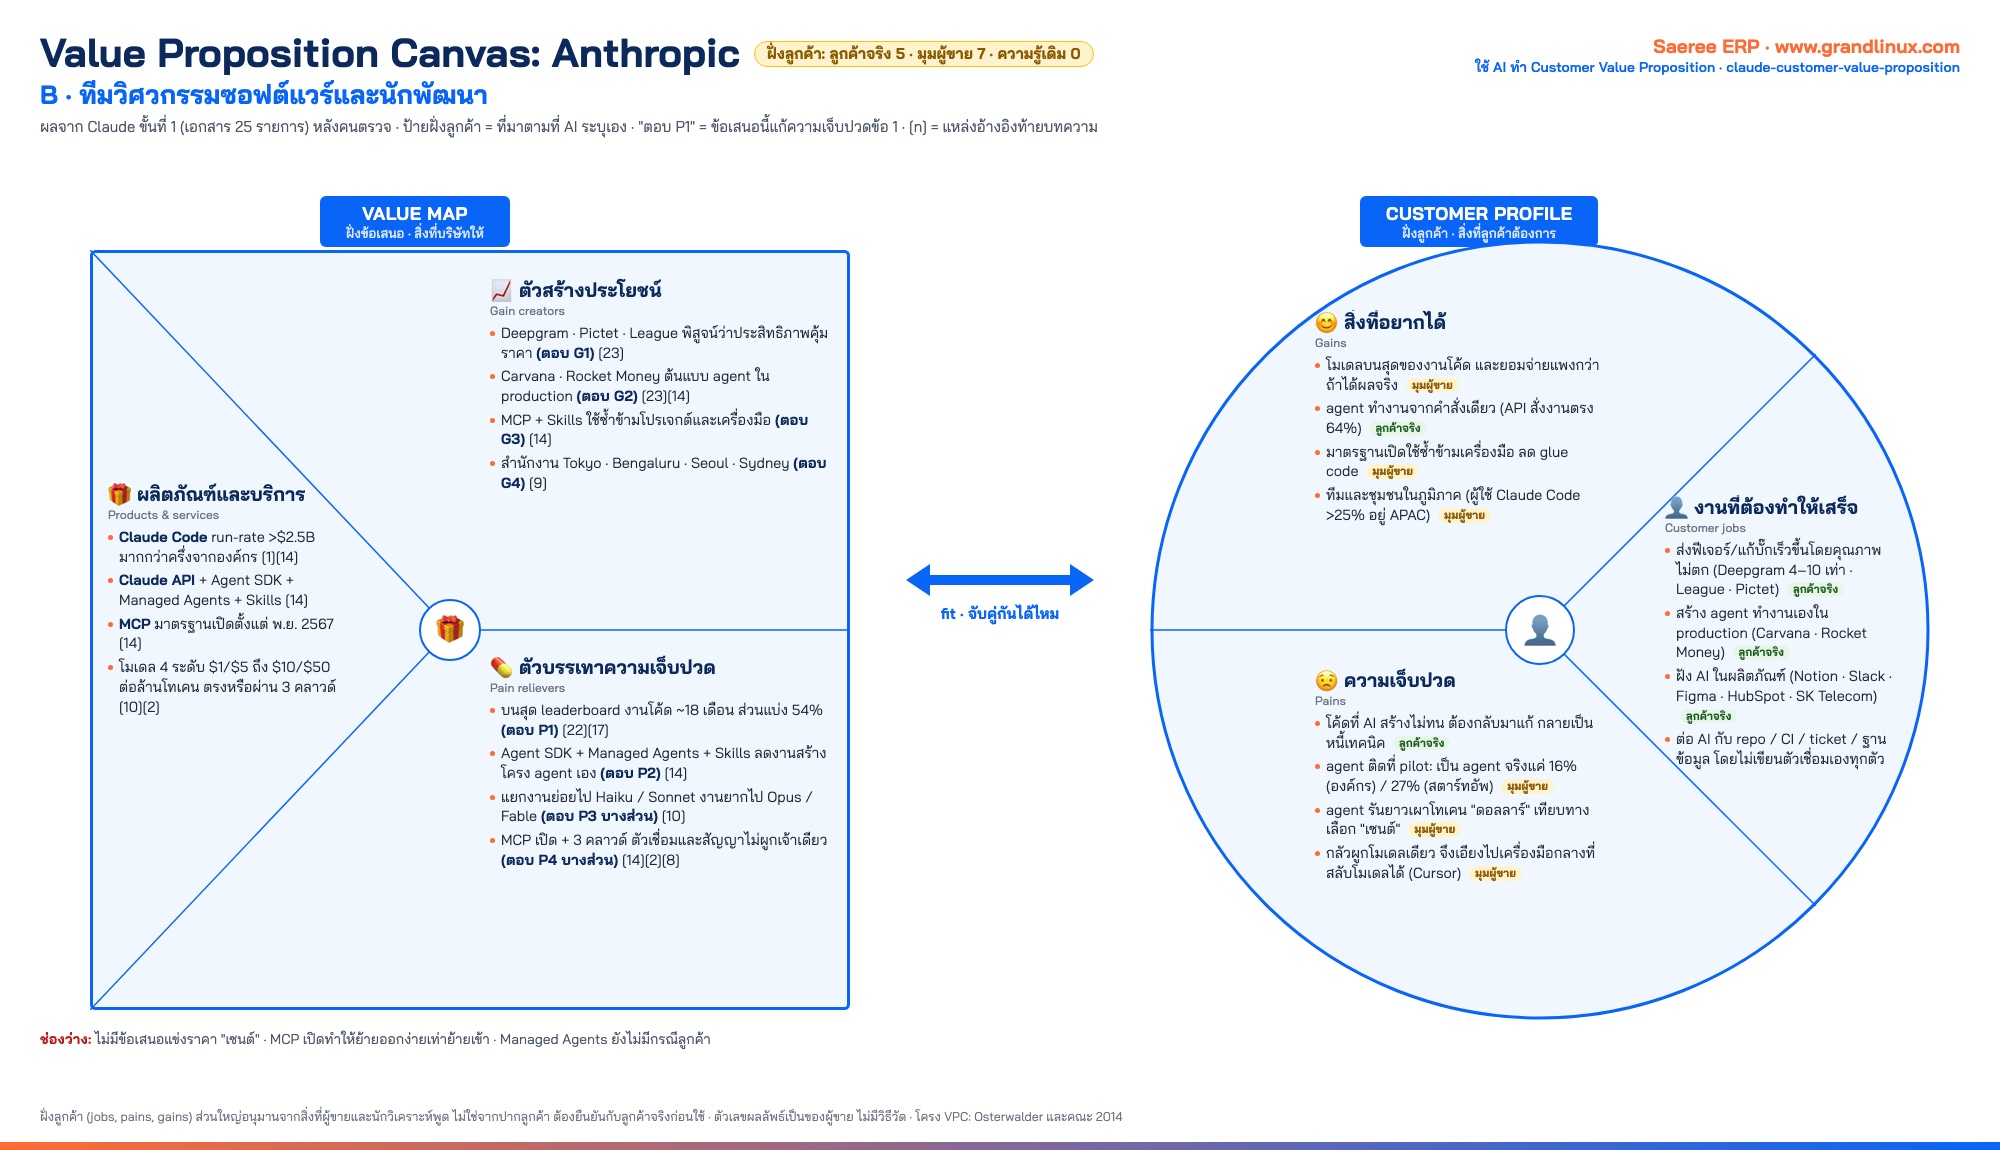
กลุ่ม B ทีมวิศวกรรมซอฟต์แวร์ กลุ่มที่มีหลักฐานจากลูกค้าจริงมากที่สุด 5 ใน 12 ข้อ
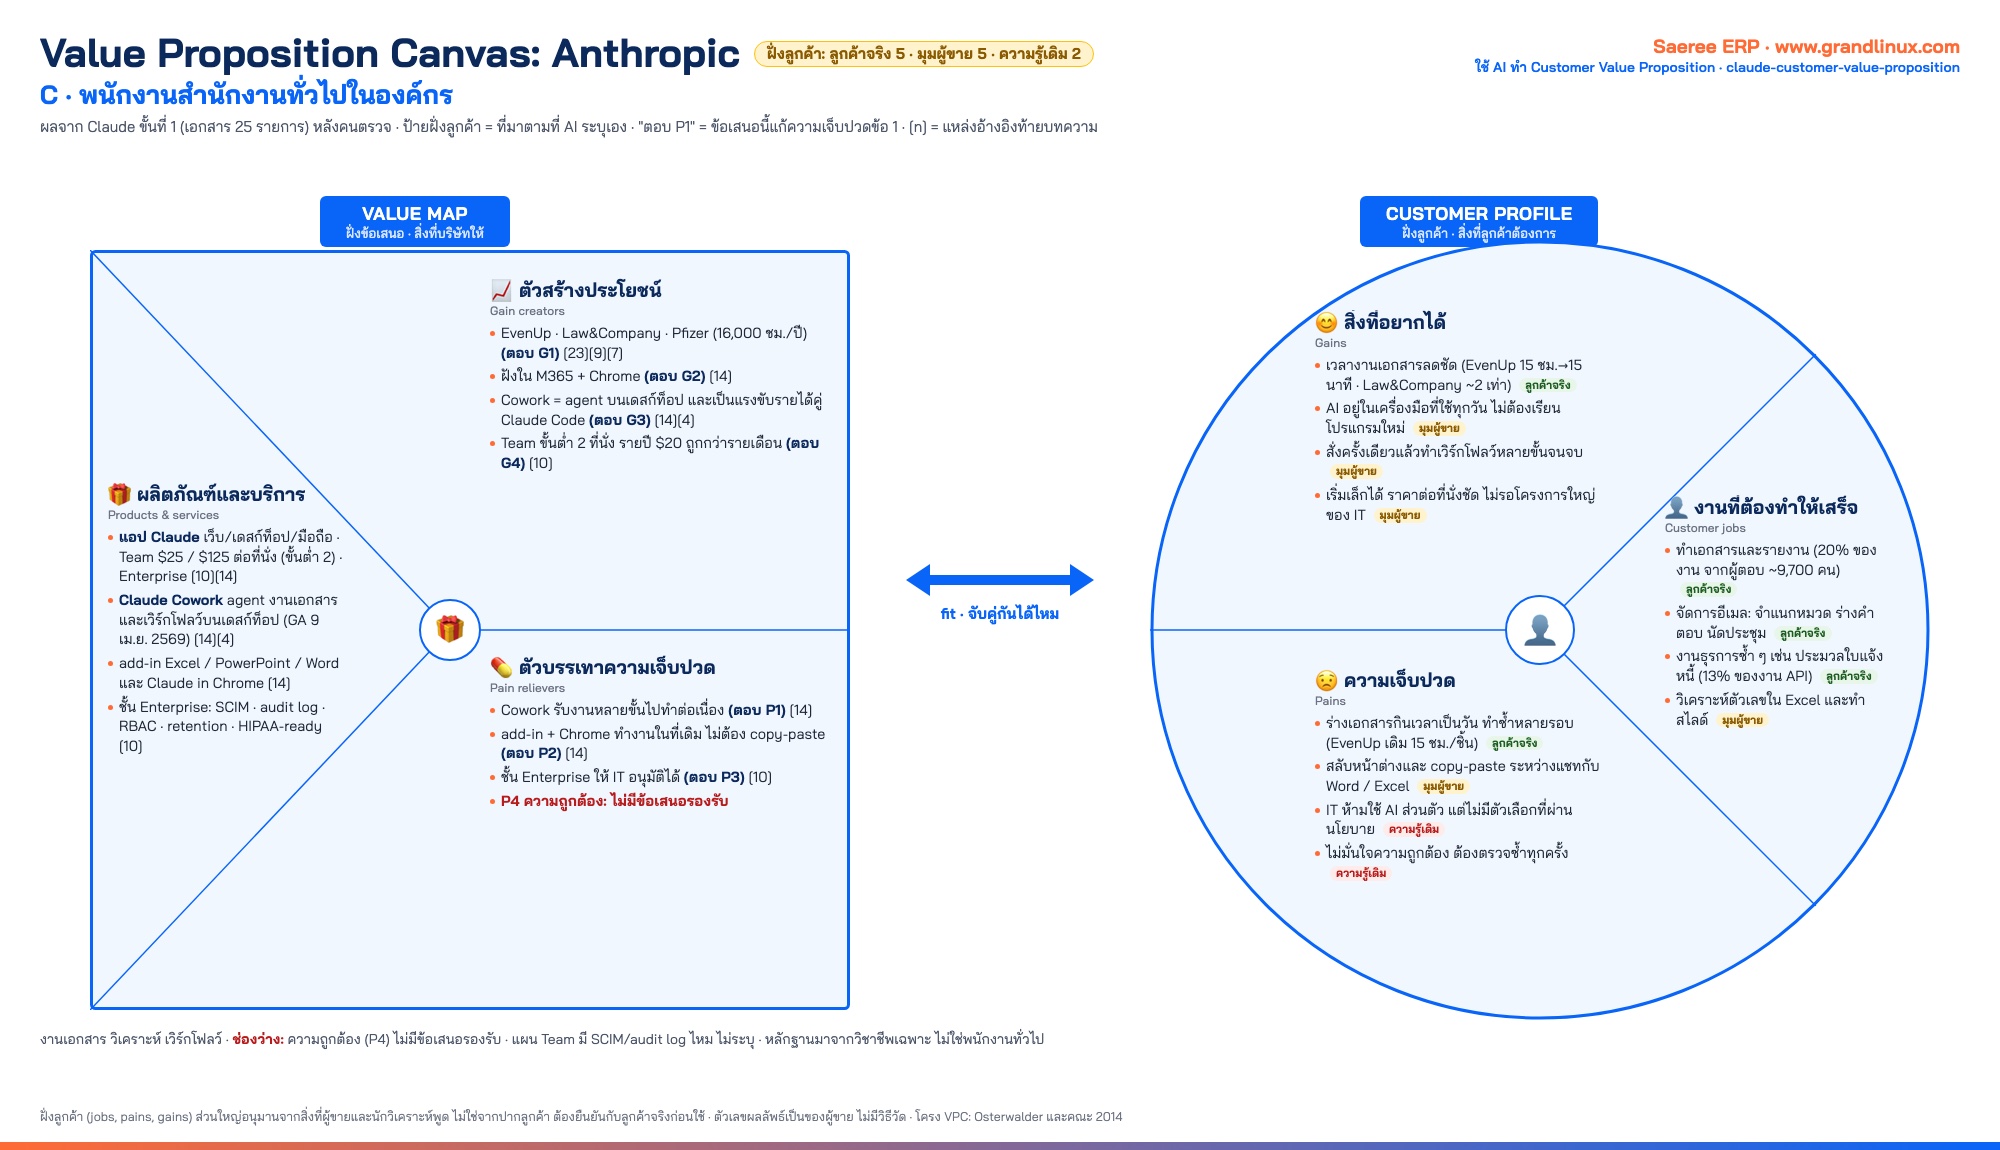
กลุ่ม C พนักงานสำนักงานทั่วไป ความเจ็บปวดเรื่องความถูกต้อง (P4) ไม่มีข้อเสนอรองรับ AI เว้นช่องไว้ให้เห็นในภาพ
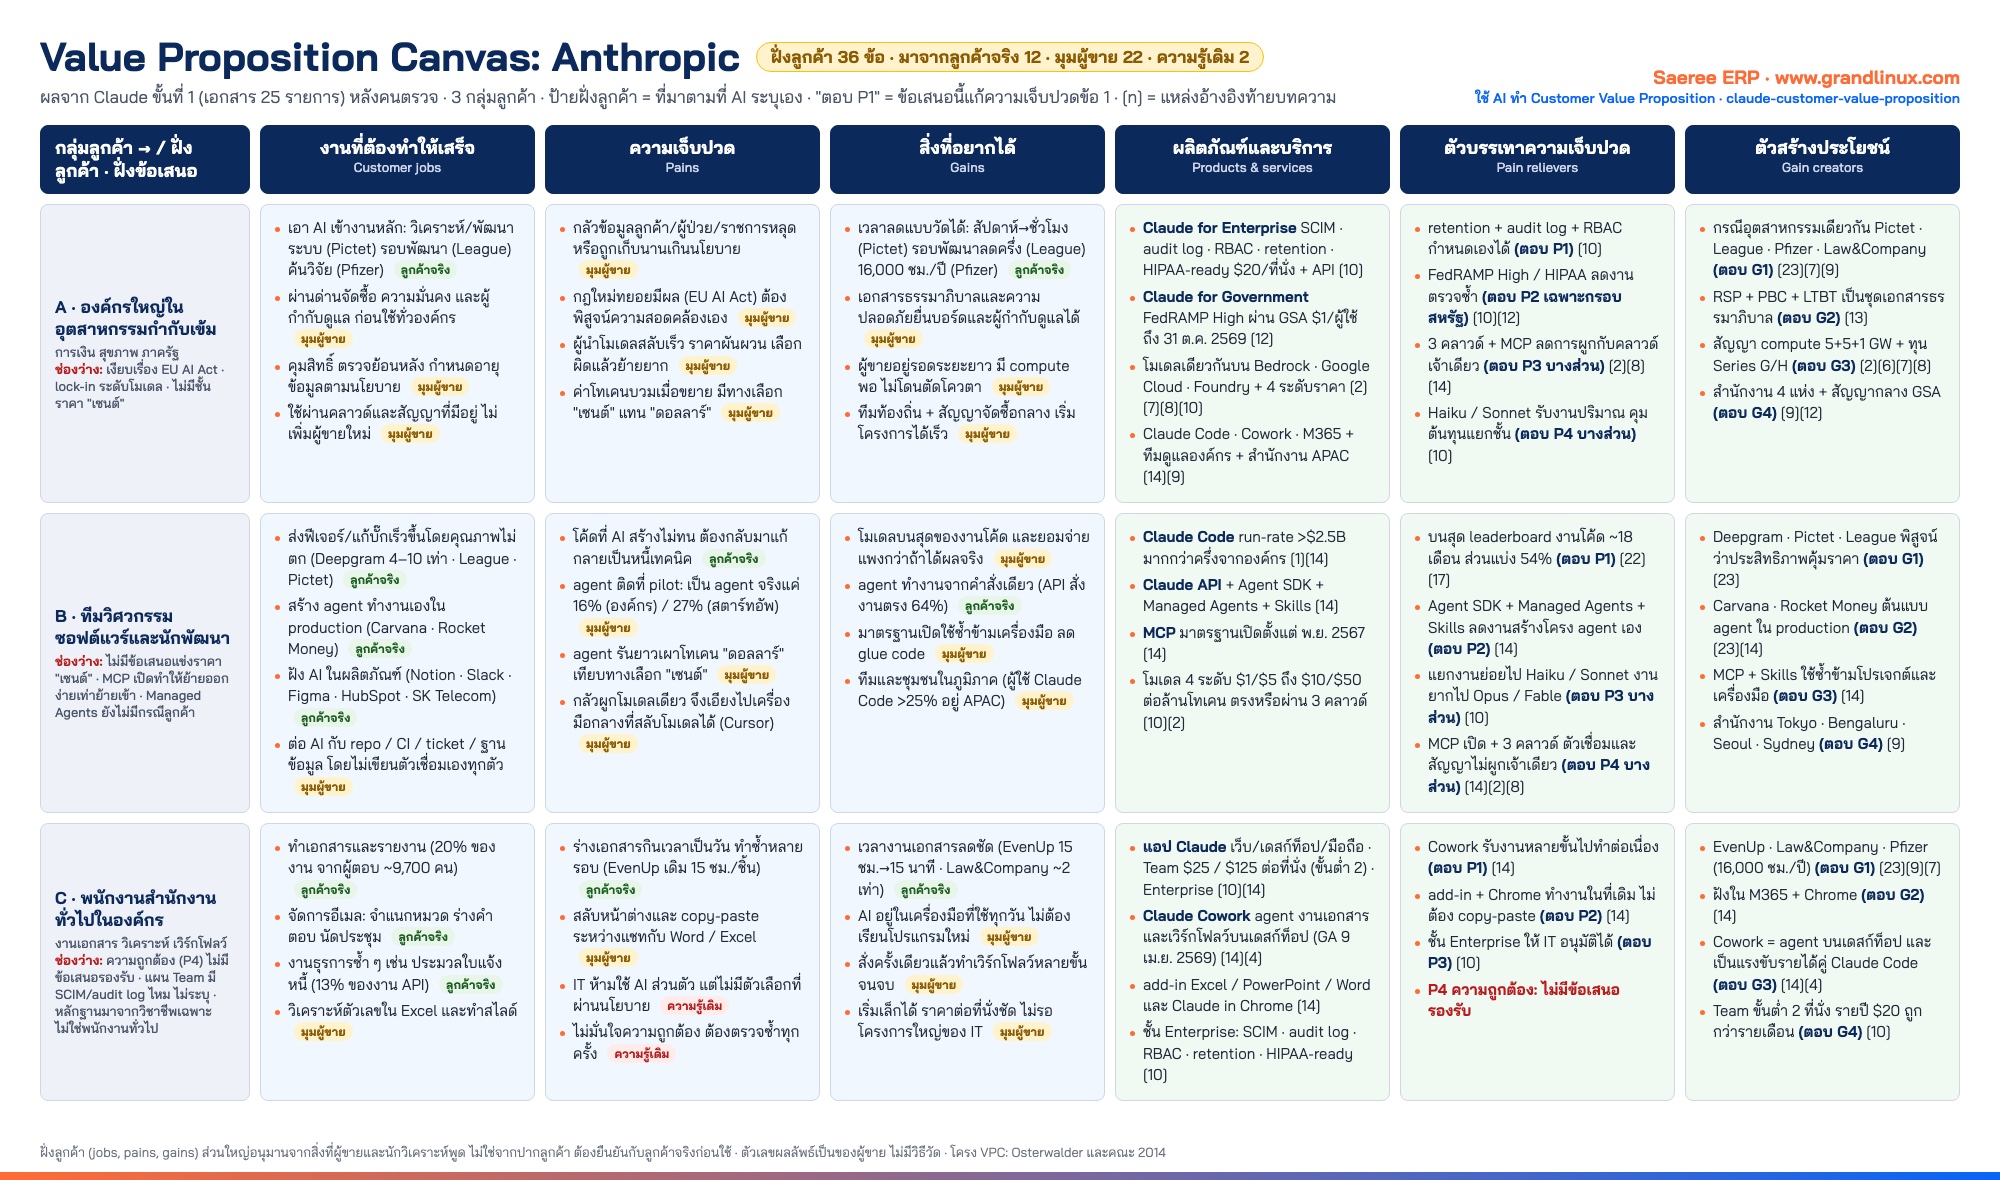
ฉบับตารางเทียบทั้ง 3 กลุ่มในหน้าเดียว ข้อความสีแดงในหัวแถวคือช่องว่างที่ AI หาเจอ ป้ายที่มาฝั่งลูกค้าเป็นของ AI เราไม่ได้แก้
สามอย่างที่ควรสังเกต
- สองในสามของฝั่งลูกค้าคือมุมผู้ขาย ฝั่งลูกค้า 36 ข้อ AI ติดป้ายว่ามาจากลูกค้าจริง 12 ข้อ อนุมานจากสิ่งที่ผู้ขาย พันธมิตร หรือนักวิเคราะห์พูด 22 ข้อ และความรู้เดิม 2 ข้อ ที่น่าสนใจคือกลุ่ม A ซึ่งเป็นกลุ่มที่สัญญาใหญ่ที่สุด มีหลักฐานจากลูกค้าจริงน้อยที่สุดคือ 2 ใน 12 เพราะเรื่องราวลูกค้าที่ผู้ขายเผยแพร่พูดถึงผลลัพธ์ ไม่ได้พูดถึงความเจ็บปวดตอนจัดซื้อ
- AI หาช่องว่างที่ผู้ขายไม่อยากพูดถึงเอง กลุ่ม A ข้อเสนอในเอกสารพูดถึงแต่กรอบสหรัฐ (FedRAMP, HIPAA) แต่เงียบเรื่อง EU AI Act ทั้งที่กฎมีผลแล้ว กลุ่ม B ไม่มีข้อเสนอที่ลงไปแข่งราคาระดับ "เซนต์" กลุ่ม C ความเจ็บปวดเรื่อง "ไม่มั่นใจความถูกต้อง ต้องตรวจซ้ำ" ไม่มีข้อเสนอไหนรองรับเลย และหลักฐานเวลาที่ลดมาจากวิชาชีพเฉพาะอย่างกฎหมายและเภสัช ไม่ใช่พนักงานสำนักงานทั่วไป
- AI ชี้ของที่ลูกค้าอาจไม่ต้องการด้วย การอยู่ครบ 3 คลาวด์ซึ่งเป็นจุดแข็งใหญ่ในตอนที่แล้ว AI บอกว่าทีมพัฒนาที่ซื้อ Claude Code เป็นที่นั่งอาจไม่สนใจเลย ดีล $1 ใช้ได้เฉพาะรัฐบาลกลางสหรัฐ และธรรมาภิบาลแบบ Public Benefit Corporation ที่ผู้ขายภูมิใจ ไม่มีหลักฐานในเอกสารว่าลูกค้าใช้เป็นเกณฑ์จัดซื้อ
| กลุ่ม | ช่องว่างที่ AI พบ (ความเจ็บปวดที่ไม่มีตัวบรรเทา) | ข้อเสนอที่อาจไม่ตรงกับกลุ่มนี้ | ตัวอย่างคำถามที่ AI ให้เอาไปถามลูกค้า |
|---|---|---|---|
| A องค์กรกำกับเข้ม | เงียบเรื่อง EU AI Act · 3 คลาวด์แก้ lock-in คลาวด์แต่ไม่แก้ lock-in โมเดล · ไม่มีชั้นราคา "เซนต์" · ภาระ compute ของผู้ขายอาจถูกอ่านเป็นความเสี่ยงราคาขึ้น | ดีล $1 เฉพาะรัฐบาลกลางสหรัฐ · ธรรมาภิบาล LTBT/RSP มาจากมุมผู้ขายทั้งหมด | "เอกสารอย่าง RSP หรือโครงสร้าง LTBT เคยถูกขอในการจัดซื้อจริงไหม หรือแค่ดูผ่าน ๆ" |
| B ทีมวิศวกรรม | ไม่มีข้อเสนอแข่งราคา "เซนต์" · MCP เปิดทำให้ย้ายออกง่ายเท่าย้ายเข้า · Managed Agents ยังเป็นคำประกาศ ไม่มีกรณีลูกค้า | 3 คลาวด์ ทีมที่ซื้อ Claude Code เป็นที่นั่งอาจไม่สนใจ · Team Premium ไม่รู้ต่างจาก Standard อย่างไร | "ถ้าโมเดลอื่นตามทันเกือบทั้งหมดแต่ราคาถูกกว่ามาก จะย้ายไหม ต่างกันแค่ไหนถึงยอมจ่าย" |
| C พนักงานสำนักงาน | ความถูกต้องของผลลัพธ์ ไม่มีข้อเสนอรองรับ · แผน Team มี SCIM/audit log ให้ IT อนุมัติไหม ไม่ระบุ · หลักฐานมาจากวิชาชีพเฉพาะ | ราคา API และ Claude Code พนักงานสำนักงานไม่ซื้อและไม่ใช้เอง | "ครั้งล่าสุดที่ AI ตอบผิดกระทบอะไร ใช้เวลาตรวจซ้ำเท่าไหร่ต่อชิ้น" |
ตาราง "สิ่งที่ต้องยืนยันกับลูกค้าจริง" ฉบับเต็มมี 24 คำถาม อยู่ในไฟล์ผลดิบที่เราเก็บไว้ · SCIM = มาตรฐานจัดการบัญชีผู้ใช้อัตโนมัติ · LTBT = Long-Term Benefit Trust · RSP = Responsible Scaling Policy
กับดักที่ต้องระวังที่สุดในงานนี้: ถ้าไม่บังคับติดป้ายที่มา VPC ที่ AI เขียนจะอ่านเหมือนมาจากการสัมภาษณ์ลูกค้า 30 ราย ทั้งที่มาจากโบรชัวร์ของผู้ขายกับข่าว ป้าย "มุมผู้ขาย" 22 ข้อคือรายการงานสัมภาษณ์ที่ยังไม่ได้ทำ ไม่ใช่ข้อเท็จจริง
4. ผลขั้นที่ 2: ข้อเสนอที่ผ่านเกณฑ์ "ต่าง วัดได้ มีหลักฐาน" ครบ มีข้อเดียว
ขั้นที่สองคือการสอบ AI ไล่ทั้ง 3 กลุ่มตามกรอบของ HBR แล้วสรุปเองว่า ข้อเสนอคุณค่าของ Anthropic ที่ผ่านเกณฑ์ resonating focus ครบทั้งสามอย่าง คือต่างจากทางเลือกถัดไป วัดได้ และมีหลักฐาน มีข้อเดียวคือคุณภาพงานโค้ดของกลุ่ม B และแม้แต่ข้อนั้นก็มีปัญหาเรื่องอายุของหลักฐาน
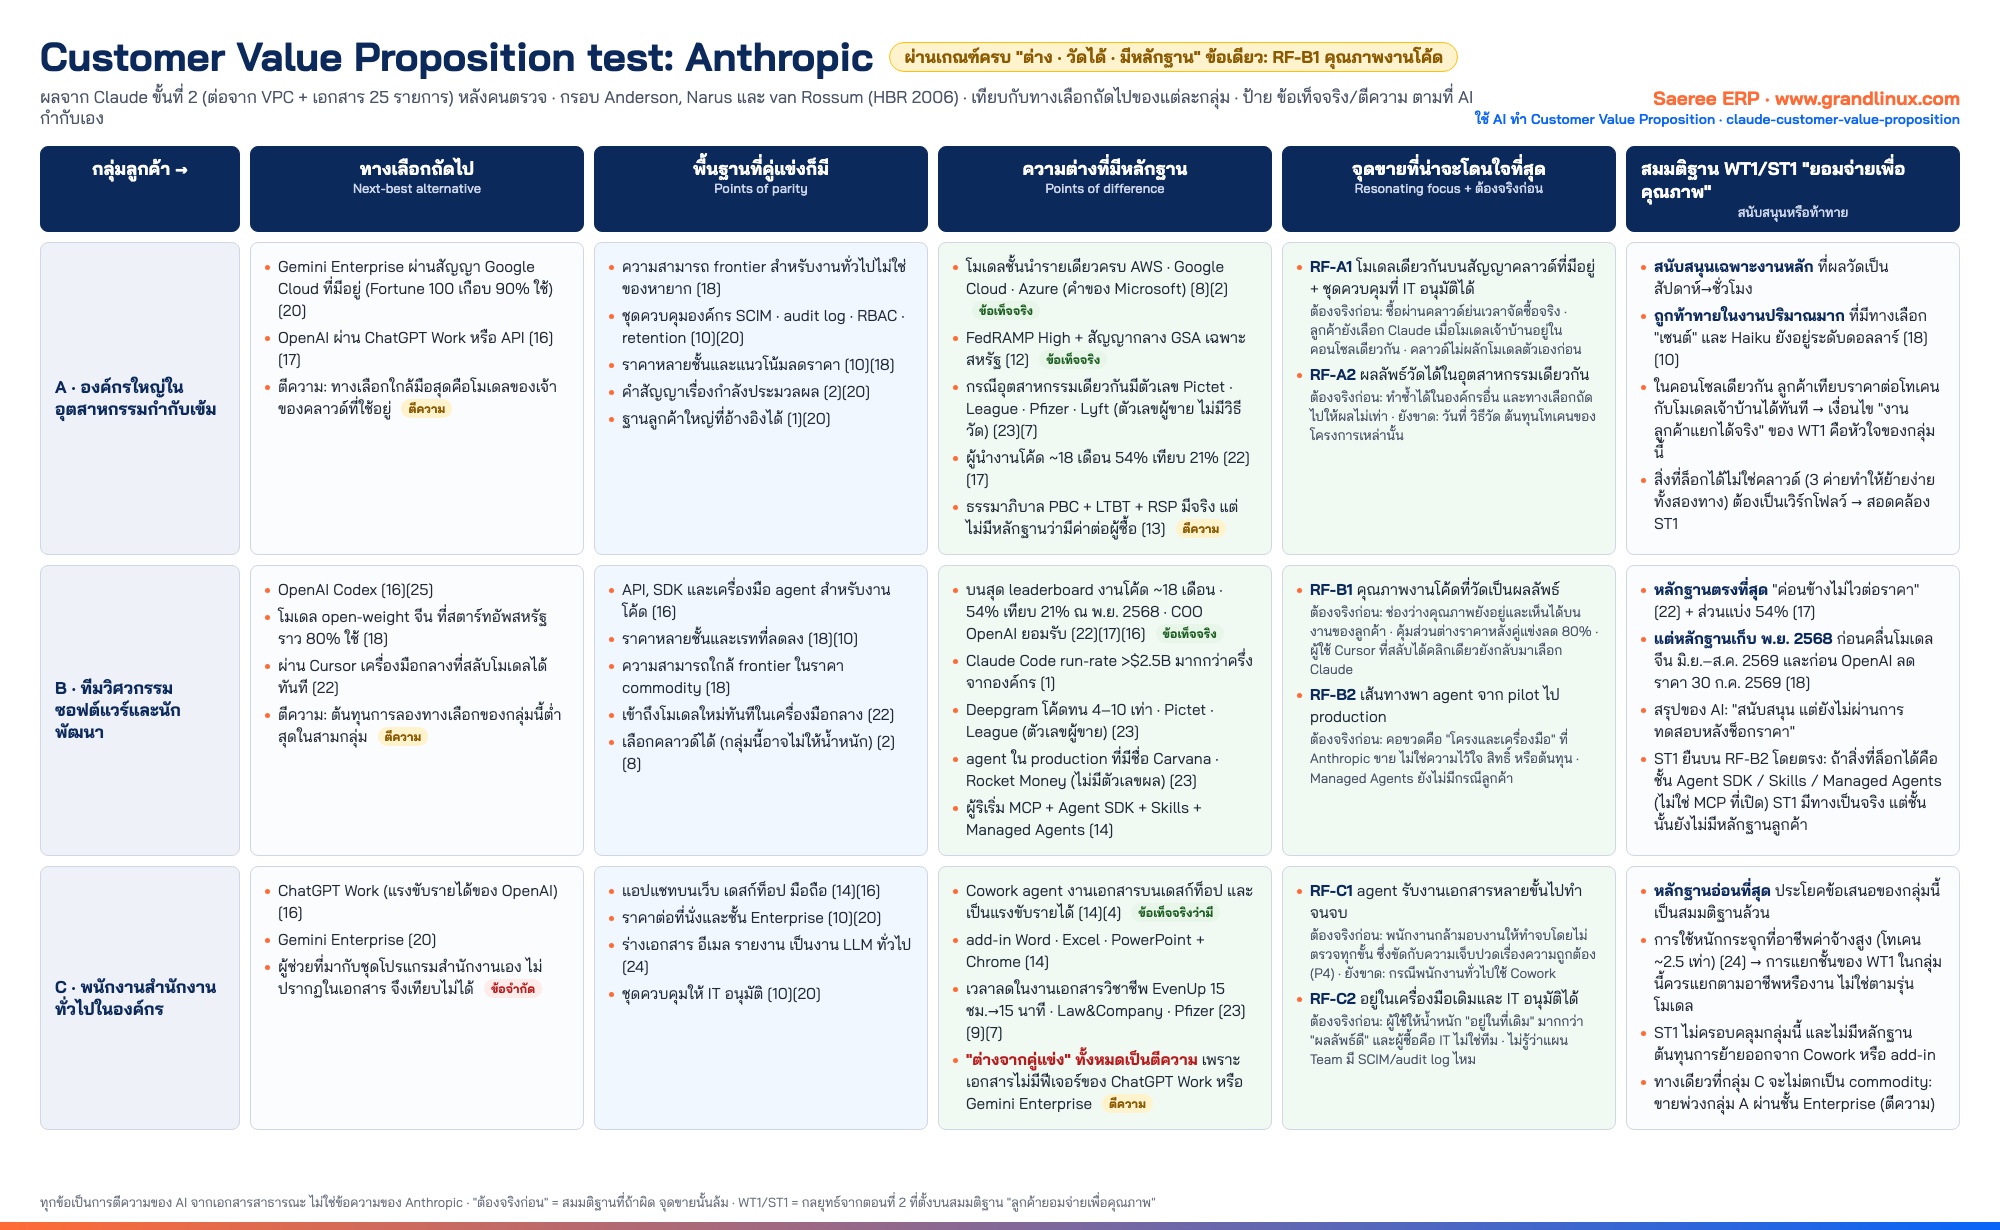
ผลสอบ CVP จากขั้นที่ 2 หลังตรวจกับแหล่ง คอลัมน์ขวาสุดคือคำตัดสินของ AI ต่อสมมติฐาน "ลูกค้ายอมจ่ายเพื่อคุณภาพ" จากตอนที่ 2 คลิกที่ภาพเพื่อเปิดขนาดเต็ม
| กลุ่ม | ทางเลือกถัดไปที่ AI เทียบ | จุดที่น่าจะโดนใจที่สุด (resonating focus) | หลักฐานที่ยังขาด (คำของ AI) | คำตัดสินต่อสมมติฐาน "ยอมจ่ายเพื่อคุณภาพ" |
|---|---|---|---|---|
| A | Gemini Enterprise ผ่านสัญญา Google Cloud ที่มีอยู่ · OpenAI | โมเดลเดียวกันบนสัญญาคลาวด์เดิม + ชุดควบคุมที่ IT อนุมัติได้ · ผลลัพธ์วัดได้ในอุตสาหกรรมเดียวกัน | ไม่มีลูกค้ารายไหนบอกว่า "เลือกเพราะอยู่บนคลาวด์ที่ใช้อยู่" · ตัวเลขผลลัพธ์ไม่มีวันที่ วิธีวัด หรือต้นทุนโทเคน | สนับสนุนเฉพาะงานหลักที่ผลเป็นสัปดาห์เหลือชั่วโมง ถูกท้าทายในงานปริมาณมากที่มีทางเลือก "เซนต์" เงื่อนไข "งานลูกค้าแยกได้จริง" ของ WT1 คือหัวใจ |
| B | OpenAI Codex · โมเดล open-weight จีน ผ่าน Cursor ที่สลับโมเดลได้ทันที | คุณภาพงานโค้ดที่วัดเป็นผลลัพธ์ · เส้นทางพา agent จาก pilot ไป production | ส่วนแบ่งและความไวต่อราคาหลัง ก.ค. 2569 · ต้นทุนรวมต่อชิ้นงานที่รวมรอบแก้ · Managed Agents ยังไม่มีกรณีลูกค้า | หลักฐานตรงที่สุด แต่เก็บ พ.ย. 2568 ก่อนช็อกราคา สรุปว่า "สนับสนุน แต่ยังไม่ผ่านการทดสอบหลังช็อกราคา" |
| C | ChatGPT Work · Gemini Enterprise (ผู้ช่วยที่มากับชุดโปรแกรมสำนักงาน ไม่มีในเอกสาร เทียบไม่ได้) | agent รับงานเอกสารหลายขั้นไปทำจนจบ · อยู่ในเครื่องมือเดิมและ IT อนุมัติได้ | กรณีพนักงานทั่วไปใช้ Cowork · ตัวเลขเวลาที่ลดจาก Cowork โดยตรง · ฟีเจอร์ของคู่แข่ง | หลักฐานอ่อนที่สุด ประโยคข้อเสนอเป็นสมมติฐานล้วน การใช้หนักกระจุกที่อาชีพค่าจ้างสูง ควรแยกชั้นราคาตามงาน ไม่ใช่ตามรุ่นโมเดล |
ประโยคข้อเสนอคุณค่าที่ AI เขียนให้กลุ่ม B ซึ่งเป็นกลุ่มที่ผ่านเกณฑ์ อ่านได้ดังนี้ "สำหรับทีมวิศวกรรมที่ต้องส่งโค้ดเร็วขึ้นโดยคุณภาพไม่ตกและพา agent จาก pilot ไป production Claude คือแพลตฟอร์มโมเดลและเครื่องมือ agent สำหรับงานโค้ดที่ให้คุณภาพโค้ดสูงกว่าทางเลือกถัดไปอย่างวัดผลได้ เพราะอยู่บนสุดของ leaderboard งานโค้ดต่อเนื่องเกือบ 18 เดือน มีส่วนแบ่งงานโค้ด 54% เทียบ 21% และลูกค้าอย่าง Deepgram ได้โค้ดที่ทนขึ้น 4–10 เท่า" แล้ว AI ต่อท้ายทันทีว่าคำว่า "วัดผลได้" อิงตัวเลขของผู้ขาย และคำว่า "สูงกว่าทางเลือกถัดไป" อิงข้อมูลเดือนพฤศจิกายน 2568
สองจุดที่ AI ทำเกินที่สั่ง และเป็นจุดที่ทำให้ผลเชื่อได้
หนึ่ง กับกลุ่ม C มันปฏิเสธที่จะบอกว่า Claude ต่างจาก ChatGPT Work หรือ Gemini Enterprise ตรงไหน โดยให้เหตุผลว่า "เอกสารไม่มีฟีเจอร์ของคู่แข่ง" ทั้งที่กติกาสั่งให้หา points of difference มันจึงเขียนว่าความต่างทั้งหมดของกลุ่มนี้เป็นการตีความ และประโยคข้อเสนอของกลุ่ม C "เป็นสมมติฐานล้วน"
สอง มันสังเกตว่าหลักฐานที่สนับสนุนจุดขายหลัก คือผลสำรวจเดือนพฤศจิกายน 2568 เก็บก่อนคลื่นโมเดลจีนเดือนมิถุนายนถึงสิงหาคม 2569 และก่อนที่คู่แข่งจะลดราคาในเดือนกรกฎาคม จึงสรุปว่า "หลักฐานสนับสนุนเก่ากว่าภัยคุกคาม" การเทียบวันที่ของหลักฐานกับวันที่ของภัย เป็นสิ่งที่นักวิเคราะห์เก่ง ๆ ทำ และคนทั่วไปมักลืม
ตาราง "สิ่งที่คนต้องตัดสินใจ" ของขั้นนี้มี 7 ประเด็น เราคัดมา 4 ประเด็นที่ตอนที่แล้วยังไม่มี
| การตัดสินใจ | ทางเลือก | หลักฐานที่ชี้ทาง (คำของ AI) | ขึ้นกับความเสี่ยงที่ยอมรับได้ |
|---|---|---|---|
| เน้นกลุ่มไหนก่อน | B ก่อน A ตาม C ท้ายสุด หรือ A ก่อนเพราะสัญญาใหญ่ | B หลักฐานแน่นสุด · A คือที่มาของบัญชีเกิน $1M กว่า 500 ราย · C หลักฐานอ่อนสุด | ยอมรับการกระจุกที่งานโค้ดได้แค่ไหน ถ้าสงครามราคากัดกลุ่ม B ก่อน การเน้น B คือเดิมพันซ้อน |
| ช่องทางกลุ่ม A | ดันผ่าน Bedrock, Google Cloud, Foundry หรือขายตรง | องค์กรกว่า 100,000 รายใช้ผ่าน Bedrock · ช่องทางรายได้ Claude Code ฝั่งองค์กรไม่ระบุ | ยอมให้เจ้าของคลาวด์เทียบ Claude กับโมเดลของตัวเองในคอนโซลเดียวกันไหม |
| เอกสาร EU AI Act | ทำก่อนกำหนด 2 ธ.ค. 2569 หรือรอ | ช่องว่างที่ AI พบ · เอกสารไม่มีสัดส่วนรายได้ยุโรป | ยอมเสียดีลยุโรปในกลุ่ม A ระหว่างรอไหม |
| ชั้น agent เปิดแค่ไหน | เปิดเหมือน MCP หรือเก็บ Agent SDK / Skills / Managed Agents เป็นจุดล็อก | ST1 ตอนที่แล้ว "ตัดสองทาง" · เอกสารระบุว่าเปิดเฉพาะ MCP | ยอมแลกการเติบโตของระบบนิเวศกับต้นทุนการย้ายของลูกค้า |
และสิ่งที่มีค่าที่สุดของขั้นนี้ไม่ใช่ประโยคข้อเสนอ แต่คือรายการคำถามที่ต้องเอาไปถามลูกค้าจริง ขั้นที่ 1 ให้มา 24 คำถาม ขั้นที่ 2 เพิ่มอีก 15 คำถามที่ไม่ซ้ำ รวม 39 คำถาม ตัวอย่างที่คมที่สุด 3 ข้อ "ในคอนโซลเดียวกัน คุณเทียบ Claude กับโมเดลของคลาวด์ด้วยอะไร ราคา คุณภาพ หรือเงื่อนไขสัญญา" "หลังคู่แข่งลดราคา 80% ทีมทดสอบซ้ำไหม ย้ายงานอะไรไปบ้าง" และ "ถ้า ChatGPT Work หรือ Gemini ราคาเท่ากันหรือถูกกว่า อะไรจะทำให้เลือก Claude"
5. สิ่งที่เรียนรู้: AI ตั้งสมมติฐานเรื่องลูกค้าได้ดีมาก แต่มันไม่ใช่ลูกค้า
สรุปจากสามตอน AI ไปได้ 4 ขั้น จัดข้อมูล แยกข้อเท็จจริงจากความเห็น จับคู่เป็นทางเลือก และตอนนี้คือตั้งสมมติฐานเรื่องลูกค้าพร้อมวิธีทดสอบ สิ่งที่มันทำไม่ได้และรู้ตัวว่าทำไม่ได้ คือยืนยันสมมติฐานนั้น เพราะคำตอบอยู่ที่ลูกค้า ไม่ได้อยู่ในเอกสารไหน
- ที่ AI ทำได้ดีกว่าที่คาด แยกที่มาของทุกข้อว่ามาจากลูกค้าหรือจากผู้ขาย หาช่องว่างที่ผู้ขายไม่พูดถึง ปฏิเสธที่จะเทียบกับคู่แข่งที่ไม่มีข้อมูล และเทียบวันที่ของหลักฐานกับวันที่ของภัย
- ที่ต้องเป็นคน เอา 39 คำถามไปถามลูกค้าจริงอย่างน้อย 5 ราย เติมข้อมูลภายในอย่างเหตุผลที่แพ้ดีลหรืออัตราการเลิกใช้ ตัดสินว่าจะเน้นกลุ่มไหน และรับผิดชอบประโยคข้อเสนอที่จะเอาไปใช้ขายจริง
- ที่ต้องระวังเป็นพิเศษ VPC ที่สวยที่สุดคือ VPC ที่ผู้ขายเขียนให้ตัวเอง ให้นับป้าย "มุมผู้ขาย" ก่อนอ่านเนื้อหาเสมอ
6. เอาไปใช้กับบริษัทตัวเอง: ฝั่งลูกค้ามาจากข้อมูลจริงและการถาม ไม่ใช่จากโบรชัวร์ของตัวเอง
บริษัทส่วนใหญ่เขียน VPC โดยให้ทีมขายและทีมผลิตภัณฑ์นั่งเดาความเจ็บปวดของลูกค้าในห้องประชุม ผลที่ได้คือ VPC แบบเดียวกับที่ AI เขียนให้ Anthropic ในขั้นที่ 1 คือมุมผู้ขาย 2 ใน 3 ทางแก้มีสองส่วน ส่วนแรกคือข้อมูลที่บันทึกพฤติกรรมลูกค้าอยู่แล้วในระบบ ส่วนที่สองคือการถาม
- ดึงสัญญาณจากระบบก่อน ความเจ็บปวดของลูกค้าทิ้งร่องรอยไว้ในระบบ ERP (Enterprise Resource Planning) เสมอ ลูกหนี้ที่จ่ายช้าเป็นประจำ การคืนสินค้าหรือขอปรับลด ระยะเวลาส่งมอบที่เกินกำหนด คำร้องเรียน ส่วนสิ่งที่ลูกค้าอยากได้ดูจากสินค้าหรือบริการที่ซื้อซ้ำ และลูกค้าที่เพิ่มยอดสั่งซื้อ ส่งออกเป็น Excel หรือ PDF ใส่วันที่ทุกไฟล์ นี่คือหลักฐาน "ลูกค้าจริง" ชุดแรกของคุณ
- ให้ AI ร่างคำถามก่อน แล้วไปถามลูกค้า 5 ราย ใช้คำสั่งขั้นที่ 1 กับข้อมูลในข้อ 1 บวกเอกสารสินค้าของคุณเอง สิ่งที่ได้จะมีป้าย "มุมผู้ขาย" เยอะ นั่นแหละคือรายการคำถามสำหรับสัมภาษณ์ลูกค้าที่ซื้อ ลูกค้าที่เลิกซื้อ และลูกค้าที่เลือกคู่แข่ง กลุ่มละอย่างน้อย 1–2 ราย
- ทำ VPC รอบสองด้วยบันทึกการสัมภาษณ์ แนบบันทึกกลับเข้าไป ป้ายจะเปลี่ยนจาก "มุมผู้ขาย" เป็น "ลูกค้าจริง" ทีละข้อ ข้อไหนที่ยังเปลี่ยนไม่ได้คือข้อที่ยังไม่ควรเอาไปใช้ขาย วิธีแนบไฟล์และให้ทีมใช้เอกสารชุดเดียวกันอ่านที่ ใช้ Claude อ่านไฟล์ Excel, CSV, PDF และ Claude Projects
- ขั้นที่ 2 ต้องบอก AI ว่าทางเลือกถัดไปของลูกค้าคือใครจริง ๆ ไม่ใช่คู่แข่งที่คุณอยากเทียบ แต่คือสิ่งที่ลูกค้าบอกในข้อ 2 ว่าเขาเทียบกับอะไร บ่อยครั้งทางเลือกถัดไปคือ "ทำเองแบบเดิม" หรือ "ไม่ทำอะไรเลย"
- ผูก resonating focus กับตัวเลขที่จะดูทุกไตรมาส ถ้าจุดขายคือ "ส่งมอบตรงเวลากว่าใคร" ตัวเลขที่ต้องดูคืออัตราส่งมอบตรงเวลาในระบบ ถ้าจุดขายคือ "ประหยัดเวลาให้ลูกค้า" ต้องเก็บตัวเลขจากลูกค้าจริงสองสามราย ไม่ใช่ประมาณเอา เรื่องบทบาทผู้บริหารกับการตัดสินใจบนข้อมูลจริง อ่านที่ ERP สำเร็จหรือล้มอยู่ที่ผู้บริหาร
จากงานของเรา: ลูกค้า Saeree ERP ดึงรายงานใบแจ้งหนี้และลูกหนี้แยกตามลูกค้า การส่งมอบและการรับคืนจากระบบคลัง และประวัติการจัดซื้อจากซัพพลายเออร์แต่ละราย เป็น Excel หรือ PDF แล้วแนบให้ Claude ทำฝั่งลูกค้าของ VPC ได้ตามขั้นตอนข้างต้น องค์กรที่ต้องการให้ Claude ถามตัวเลขเหล่านี้จาก ERP ได้โดยตรงทุกไตรมาส เราเชื่อมผ่าน MCP (Model Context Protocol) แบบกำหนดสิทธิ์ตามบทบาทและเก็บบันทึกทุกคำถาม ระบบ ERP ยังเป็นแหล่งข้อมูลจริง Claude เป็นผู้ช่วยตั้งสมมติฐานและร่างคำถาม ส่วนคำตอบสุดท้ายอยู่ที่ลูกค้าของคุณ ดูรูปแบบงานที่ Claude Solutions และแนวคิดที่ MCP คืออะไร
สรุป
- AI ทำ Value Proposition Canvas ให้ลูกค้า 3 กลุ่มได้ครบ 6 ช่อง และติดป้ายเองว่าฝั่งลูกค้า 36 ข้อ มาจากลูกค้าจริง 12 ข้อ ที่เหลือเป็นมุมผู้ขายหรือความรู้เดิม
- AI หาช่องว่างที่ผู้ขายไม่พูดถึงได้เอง เช่น เงียบเรื่อง EU AI Act ไม่มีชั้นราคา "เซนต์" และไม่มีข้อเสนอรองรับเรื่องความถูกต้องของผลลัพธ์
- เมื่อสอบด้วยกรอบของ HBR ข้อเสนอที่ผ่านเกณฑ์ "ต่าง วัดได้ มีหลักฐาน" ครบ มีข้อเดียวคือคุณภาพงานโค้ด และหลักฐานของมันเก่ากว่าภัยคุกคามด้านราคา
- สมมติฐาน "ลูกค้ายอมจ่ายเพื่อคุณภาพ" จากตอนที่ 2 ได้รับการสนับสนุนในกลุ่มนักพัฒนา ถูกท้าทายในงานปริมาณมาก และไม่มีหลักฐานเลยในกลุ่มพนักงานสำนักงาน
- ของที่มีค่าที่สุดที่ AI ให้มาคือ 39 คำถามสำหรับถามลูกค้าจริง ไม่ใช่ประโยคข้อเสนอ
- สำหรับบริษัทของคุณ ฝั่งลูกค้าของ VPC ต้องมาจากร่องรอยในระบบและการสัมภาษณ์ ให้ AI ทำหน้าที่ตั้งสมมติฐานและร่างคำถาม ไม่ใช่ตอบแทนลูกค้า
AI เขียนข้อเสนอคุณค่าที่อ่านลื่นได้ในสิบนาที แต่ประโยคที่ลื่นที่สุดมักมาจากโบรชัวร์ของผู้ขาย ไม่ใช่จากปากลูกค้า สิ่งที่ AI ให้ได้จริงคือรายการคำถาม คำตอบยังต้องไปเอาจากลูกค้าเอง
- ข้อสรุปจากการทดลองตอนที่ 3 26 กันยายน 2569
แหล่งอ้างอิง
- [1] Anthropic: Anthropic raises $30B Series G at $380B post-money valuation (12 ก.พ. 2569)
- [2] Anthropic: Anthropic raises $65B Series H at $965B valuation (28 พ.ค. 2569)
- [3] TechCrunch (อ้าง Bloomberg): Anthropic's annualized revenue surges to $65B (17 ส.ค. 2569)
- [4] Axios (อ้าง The New York Times): Anthropic tops $100 billion revenue pace, report says (18 ก.ย. 2569)
- [5] Anthropic: Expanding our use of Google Cloud TPUs and services (23 ต.ค. 2568)
- [6] Anthropic: Anthropic expands Google and Broadcom compute deal (6 เม.ย. 2569)
- [7] Amazon: Amazon announces $5B Anthropic investment, up to $20B more (20 เม.ย. 2569)
- [8] Microsoft: Microsoft, NVIDIA and Anthropic announce strategic partnerships (18 พ.ย. 2568)
- [9] Anthropic: Seoul becomes third Anthropic office in Asia-Pacific (และ Sydney fourth office, 10 มี.ค. 2569) (23 ต.ค. 2568)
- [10] Claude: Pricing page (ตรวจ 26 ก.ย. 2569)
- [11] Yahoo Finance: Anthropic's gross margin is the most important number in tech (10 มิ.ย. 2569)
- [12] GSA: GSA strikes another OneGov deal with Anthropic (ขยายถึง 31 ต.ค. 2569 ตามรายงาน Nextgov ก.ย. 2569) (12 ส.ค. 2568)
- [13] Anthropic: The Long-Term Benefit Trust (ก.ย. 2566)
- [14] Anthropic: Claude Cowork และหน้าผลิตภัณฑ์ที่ claude.com (ตรวจ 26 ก.ย. 2569)
- [15] Sacra: Anthropic revenue, valuation & funding (ประมาณการบุคคลที่สาม) (2569)
- [16] Yahoo Finance / Quartz (อ้าง Bloomberg): OpenAI annualized revenue tops $40 billion ahead of IPO (14 ส.ค. 2569)
- [17] Menlo Ventures: 2025 — The State of Generative AI in the Enterprise (9 ธ.ค. 2568)
- [18] State Street Investment Management: Beyond DeepSeek — China's 2026 model wave and the repricing of the AI stack (21 ก.ย. 2569)
- [19] EU Artificial Intelligence Act: Implementation timeline (อัปเดต 31 ส.ค. 2569)
- [20] PYMNTS: Google Cloud rides enterprise AI demand to 82% growth (ผลประกอบการ Alphabet Q2/2569) (22 ก.ค. 2569)
- [21] บทความตอนที่ 1 ของเรา: ใช้ AI เขียน Business Model Canvas ได้แค่ไหน? — BMC ที่ตรวจแล้ว (26 ก.ย. 2569)
- [22] Menlo Ventures (รายงานเดียวกับ [17]) ส่วนที่ว่าด้วยเหตุผลที่องค์กรเลือกผู้ขายและความไวต่อราคา (9 ธ.ค. 2568)
- [23] Claude: Customer stories (Spellbook, EvenUp, Deepgram, Pictet, League, Carvana ฯลฯ ตรวจ 26 ก.ย. 2569)
- [24] Anthropic Economic Index: Economic primitives (15 ม.ค. 2569) และ Cadences (26 มิ.ย. 2569)
- [25] บทความตอนที่ 2 ของเรา: ใช้ AI ทำ SWOT และ TOWS Matrix ได้แค่ไหน? — สมมติฐาน WT1/ST1 (26 ก.ย. 2569)
- Strategyzer: The Value Proposition Canvas (Osterwalder, Pigneur, Bernarda, Smith, 2014)
- Anderson, Narus & van Rossum (2006): Customer Value Propositions in Business Markets, Harvard Business Review
อยากทำ Value Proposition ของบริษัทคุณจากร่องรอยลูกค้าจริงในระบบ?
บริการจัดหา Claude Team และ Enterprise พร้อมใบเสนอราคาเป็นเงินบาทและใบกำกับภาษี รับตั้งแต่ 5 ที่นั่ง และงานเชื่อม Claude กับข้อมูลลูกหนี้ การส่งมอบ และการจัดซื้อใน ERP ผ่าน MCP แบบกำหนดสิทธิ์ตามบทบาท
ปรึกษา / ขอใบเสนอราคาโทร 02-347-7730 | sale@grandlinux.com